 Por Gustavo Torres
Una tienda online guarda sus pedidos en Postgres, en una tabla pedidos de 3 millones de filas.
Postgres no guarda esas filas sueltas, sino en páginas: bloques de 8 KB, todos del mismo
tamaño, que lee y escribe siempre enteros, aunque sólo le interese una fila de las que contienen.
En cada página de pedidos caben unas 136 filas, y la tabla ocupa 22 059. Para encontrar el pedido
1 234 567, Postgres lee cuatro páginas: tres de su índice sobre id y una de la tabla, la que
contiene la fila. El índice es una estructura aparte, también hecha de páginas, que dice en qué
página de la tabla está cada id. Si en lugar del índice que crea por defecto se le pide uno
hash, lee tres. La tabla hash es la estructura clásica para encontrar una clave sin importar
cuántas haya, y Postgres la ofrece con la misma orden que la otra:
CREATE INDEX ON pedidos USING hash (id);Con las otras dos preguntas que se le suelen hacer a una columna id, la cuenta cambia:
| Índice por defecto (árbol B) | Índice hash | |
|---|---|---|
WHERE id = 1234567 | 4 páginas | 3 páginas |
WHERE id BETWEEN 1234567 AND 1235566 (mil pedidos) | 14 páginas | 22 080 páginas |
ORDER BY id DESC LIMIT 10 | 4 páginas | 22 083 páginas |
Con el índice hash, pedir mil pedidos seguidos o los diez últimos obliga a leer la tabla entera,
porque un hash no sabe qué claves van juntas. El índice por defecto, un árbol B, los encuentra
en catorce páginas y en cuatro. Por eso Postgres lo crea si no se le dice otra cosa, y no es el
único. En MySQL ni siquiera hay que elegir: InnoDB acepta USING HASH, avisa con una nota de que
no lo soporta y crea un árbol B igualmente. SQLite no tiene otro tipo de índice, y SQL Server y
Oracle también crean un árbol B salvo que se les pida otra cosa.
Hay muchas más formas de buscar: ordenar los datos y buscar por bisección, tablas hash, árboles binarios equilibrados, listas con saltos, árboles de prefijos. Varias son mejores que el árbol B en lo que mejor sabe hacer cada una. La pregunta es por qué casi todas las bases de datos que guardan sus datos en disco eligieron la misma estructura hace cincuenta años y siguen con ella, y la respuesta tiene tres partes. La primera es lo que cuesta buscar: en una base de datos, lo caro no es comparar claves sino leer páginas, y eso cambia qué estructura es rápida. La segunda es lo que se le pide a un índice, que es bastante más que encontrar una clave. La tercera es que el árbol B, y sobre todo su variante, el árbol B+, es la única estructura que hace todo eso leyendo pocas páginas, aunque no sea la mejor en ninguna de esas cosas por separado.
Todos los números del artículo están medidos. La tienda es inventada: la genera, con semillas fijas, un script público, el mismo del artículo sobre cómo ejecuta un JOIN la base de datos, así que cualquiera puede repetir las mediciones. Los motores son Postgres 18.6, MySQL 9.4 y SQLite 3.45, los dos primeros en Docker, en un portátil de cuatro núcleos con un SSD SATA. Cada tiempo es la mediana de tres ejecuciones.
El árbol B tiene más de cincuenta años, y casi todas las alternativas que han aparecido después se pensaron para otra situación: datos que caben enteros en memoria, o muchas más escrituras que lecturas.
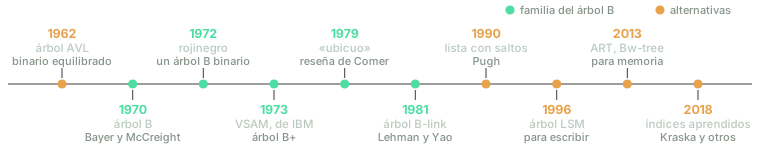
No a escala. En verde, el árbol B y sus variantes; en naranja, las estructuras que se pensaron para otra cosa.
Lo que cuesta buscar
En el portátil de prueba, comparar dos números enteros cuesta un par de nanosegundos, y encontrar una clave entre 367 ordenadas con una búsqueda binaria, unos 100. Leer del SSD una página de 8 KB cuesta unos 300 microsegundos: lo mismo que tres mil búsquedas binarias completas. Un disco duro mecánico, el que había cuando se inventó el árbol B, tarda unos 8 milisegundos en llevar el cabezal hasta la página, lo mismo que ochenta mil.
Por eso las bases de datos trabajan por páginas. El disco y el sistema operativo leen por bloques, y leer un byte cuesta lo mismo que leer la página entera, así que la base de datos agrupa las filas en bloques de tamaño fijo y se trae siempre la página completa. Postgres usa páginas de 8 KB; InnoDB, el motor de almacenamiento de MySQL, de 16, y SQLite de 4. De ahí sale la regla que decide todo lo demás: la unidad de coste de una búsqueda no es la comparación, es la página que no está en memoria. Lo que un algoritmo haga dentro de una página que ya ha leído es casi gratis.
Dónde esté la página importa tanto como cuántas haya que leer. Una página leída hace poco puede seguir en memoria en dos sitios: en la caché de Postgres, la memoria que reserva para las páginas que ha usado, o en la del sistema operativo, que guarda los trozos de fichero leídos recientemente. La búsqueda del principio, cuatro páginas, cuesta 20 microsegundos si las cuatro están en la caché de Postgres, 43 si están en la del sistema operativo y 790 si hay que ir a buscarlas al SSD, casi todos ellos esperando al disco. Así que la cuenta que importa no es la de los libros, comparaciones, sino cuántas páginas hay que leer y cuántas de ellas no estarán ya en memoria.
La otra mitad de la respuesta es qué se le pide a un índice. Encontrar una clave es el primer trabajo, no el único. Un índice de una base de datos tiene cuatro:
- Encontrar una clave.
WHERE id = 42, y comprobar que una clave no está repetida antes de aceptar una fila nueva. - Recorrer un rango o un orden.
BETWEEN,>,ORDER BY ... LIMIT,min(),LIKE 'abc%', o unir dos tablas recorriéndolas a la vez en orden, como dos listas ordenadas que se cruzan. - Seguir el ritmo de las escrituras. Cada
INSERT,UPDATEoDELETEcambia también el índice, y no se puede reconstruir entero cada vez. - Aguantar a muchos a la vez, y un apagón. Cientos de sesiones leyendo y escribiendo el mismo índice, y que después de una caída siga siendo correcto.
Con esa lista, y contando páginas, se puede medir cada alternativa.
Las alternativas, y dónde se rompe cada una
No tener índice. Sin índice, encontrar el pedido 1 234 567 es leer las 22 059 páginas. No es tan malo como suena, porque se leen en orden, y leer en orden es lo más barato que sabe hacer un disco: el sistema operativo ve venir la siguiente página y la trae antes de que se la pidan. Cuando una consulta necesita buena parte de la tabla, leerla entera en orden sale más barato que saltar de página en página siguiendo un índice, y por eso una base de datos a veces ignora el índice que tienes. Escribir es gratis, porque no hay nada que mantener. Pero para encontrar un pedido, o los diez últimos, no sirve.
Ordenar la tabla y buscar por bisección. La tabla pedidos ya está ordenada por id, porque
los pedidos se guardaron según llegaban. Una búsqueda binaria sobre sus páginas encuentra
cualquiera en lecturas. Las primeras son siempre las mismas
(la página del medio, las de los cuartos, las de los octavos), así que se quedarían en memoria:
con 31 páginas en caché quedarían diez lecturas. Recorrer un rango es gratis, porque los datos ya
están en orden. El problema es el tercer trabajo. Una tabla sólo puede estar ordenada por una
columna, y para buscar por cliente_id haría falta otra copia ordenada por cliente_id, en la
que cada pedido nuevo caería en medio. Meter una fila en medio de un fichero ordenado es correr
todo lo que va detrás: de media, la mitad del fichero.
IBM lo resolvió en los años sesenta con ISAM (Indexed Sequential Access Method, método de acceso secuencial indexado). Un método de acceso era el código del sistema operativo de sus grandes ordenadores que decidía cómo se guardaba un fichero en el disco y cómo se buscaba en él, y ISAM era el de los ficheros ordenados por una clave. Un fichero ISAM tiene tres partes: los datos, ordenados; un índice pequeño y fijo que dice en qué zona del disco está cada tramo de claves; y una zona de desbordamiento, donde van, encadenadas, las filas nuevas que no caben en su sitio. Funciona mientras las cadenas son cortas. Cuando crecen, cada búsqueda las recorre, y hay que parar y reorganizar el fichero entero. ISAM tenía ya la forma de la respuesta, datos ordenados con un índice encima; le faltaba poder cambiar sin pararse.
Una tabla hash. Una función hash convierte la clave en un número, y ese número dice en qué
casillero (bucket, en inglés) está guardada. En un índice hash, cada casillero es una página. Da
igual cuántas filas tenga la tabla: el índice hash de pedidos lee dos páginas, y la tercera es la
fila. Para el primer trabajo no hay nada mejor. Para el segundo no sirve, y no por un defecto de
implementación. Una buena función hash reparte las claves a propósito: 1 234 567 y 1 234 568 acaban
en casilleros que no tienen nada que ver, así que no hay forma de pedir «las siguientes». Tampoco
sirve del todo para el primero: Postgres no admite índices hash UNIQUE, así que una clave primaria
no puede ser un hash. Y el cuarto trabajo tardó: hasta Postgres 10, en 2017, los índices hash no se
escribían en el WAL (write-ahead log, registro de escritura anticipada), el fichero en el que la
base de datos anota cada cambio antes de hacerlo, para poder rehacerlo si se apaga a medias. Sin
esas anotaciones, después de una caída había que reconstruirlos a mano. Eso se arregló. Lo del orden
no se puede arreglar, porque es lo que hace una función hash.
Un árbol binario equilibrado. Un árbol AVL, de 1962, que lleva las iniciales de sus autores,
Adelson-Velski y Landis, o un rojinegro, el que hay detrás de
std::map en C++ y de TreeMap en Java. Cada nodo guarda una clave y dos hijos, el de las
menores y el de las mayores, y el árbol se reequilibra con rotaciones para que ninguna rama sea
mucho más larga que otra. Está ordenado, se modifica en y recorre un rango en orden:
tres de los cuatro trabajos, en memoria. En disco, el problema es el tamaño del nodo. Una clave y
dos punteros ocupan unos pocos bytes, y una página tiene 8192. Si cada nodo es una página, los 3
millones de claves necesitan 22 niveles, porque : 22 lecturas por
búsqueda, más la de la fila, y 17 si se guardan en memoria los cinco niveles de arriba. Y 3
millones de páginas de 8 KB son 24 GB, para guardar lo que el índice de Postgres guarda en 8 228
páginas.
La idea obvia es meter muchos nodos en cada página: con un subárbol de ocho niveles, 255 nodos, por página, la búsqueda se quedaría en tres páginas. Es la forma correcta, y es justo donde se rompe. Para mantenerse equilibrado, el árbol binario rota nodos, y cada rotación cerca de la raíz de un subárbol saca nodos de su página y los lleva a otra. Mantener a la vez el árbol equilibrado y cada página llena de nodos que van juntos es lo difícil, y es lo que resuelve el árbol B cambiando la regla.
Estructuras pensadas para memoria. Una lista con saltos (skip list, de 1990) es una lista ordenada con atajos: cada elemento tiene, elegidos al azar, enlaces que se saltan de media dos, cuatro u ocho elementos, y buscar es avanzar por los atajos largos mientras no se pase de la clave. La usan Redis, una base de datos que vive en memoria, para sus conjuntos ordenados, y RocksDB, un motor de almacenamiento, para los datos recién escritos. Un árbol de prefijos no compara claves enteras: baja por la clave trozo a trozo, como se busca una palabra en el diccionario letra a letra. El ART (Adaptive Radix Tree, árbol de prefijos adaptativo), de 2013, es el que usa para sus índices DuckDB, una base de datos para análisis. Son excelentes cuando todo cabe en memoria, porque allí lo caro es otra cosa, un fallo de la caché del procesador, y están diseñadas para eso. En disco tienen el problema del árbol binario: muchos nodos pequeños unidos por punteros, y cada puntero que sale de la página es otra lectura.
| Páginas para encontrar un pedido | Rangos y orden | Insertar | Pensada para | |
|---|---|---|---|---|
| Sin índice | las 22 059, en orden | leyendo todo | gratis | consultas que leen mucho |
| Fichero ordenado (ISAM) | 15 | sí | correr media tabla, o desbordar | datos que no cambian |
| Tabla hash | 3 | no | barato | igualdades |
| Árbol binario, nodo por página | 23 | sí | barato | memoria |
| Skip list, ART | una por nodo | sí | barato | memoria |
Lo que falta es algo ordenado, como el fichero y el árbol binario; que lea pocas páginas, como el hash; y que se pueda modificar sin reorganizar nada.
El árbol B: un nodo, una página
En otoño de 1969, Rudolf Bayer le explicó a Edward McCreight, su compañero en los laboratorios de investigación de Boeing, una idea para ese problema. El informe salió en julio de 1970, y el árbol B se publicó en una revista en 1972. Nunca dijeron qué significa la B: se ha propuesto Boeing, Bayer, balanced (equilibrado), broad (ancho). McCreight contó años después que cuanto más se piensa en qué significa la B, mejor se entienden los árboles B.
La idea es cambiar el tamaño del nodo. En lugar de una clave con dos hijos, cada nodo es una página entera, con cientos de claves ordenadas y un hijo entre cada dos: un nodo con claves tiene hijos. Las claves de un nodo hacen de postes que separan a sus hijos. Si un nodo tiene las claves 30 y 50, todo lo que hay bajo el hijo que queda entre ellas es mayor que 30 y menor que 50. El árbol cumple cuatro reglas:
- Las claves de cada nodo están ordenadas.
- Un nodo con claves tiene hijos, salvo las hojas, que no tienen ninguno.
- Todo nodo, menos la raíz, está al menos medio lleno.
- Todas las hojas están a la misma profundidad.
La última es la garantía: no hay ramas largas. Cualquier búsqueda lee exactamente un nodo por nivel.
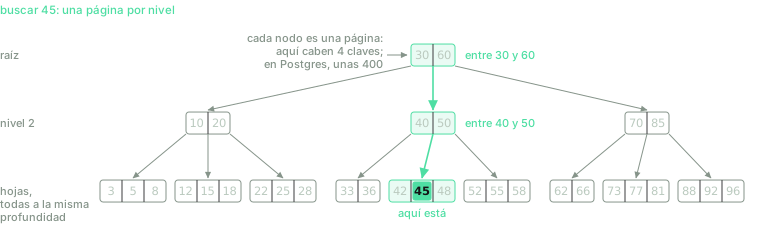
Un árbol B pequeño, con cuatro claves como mucho por nodo. Para buscar el 45 se lee una página por nivel: en cada una, las claves dicen entre qué dos postes cae el 45, y con eso, por qué hijo seguir.
Buscar es bajar
En cada página, una búsqueda binaria entre sus claves dice por qué hijo seguir, y se lee ese
hijo. El índice de pedidos.id tiene tres niveles. La raíz tiene 29 entradas, una por cada página
del nivel de en medio. Esas 29 páginas tienen unas 284 entradas cada una, y apuntan a 8 197 hojas
de 367 claves. Son 8 228 páginas, y sólo 30 no son hojas: 240 KB.
Cuántos niveles hacen falta lo decide cuántos hijos tiene cada nodo, que se llama el orden del árbol. Con hijos por nodo, claves caben en unos niveles. Un árbol binario tiene , y para 3 millones de claves necesita 22. Este índice tiene y necesita 3. El de las líneas de pedido, otra tabla de la tienda con 7,5 millones de filas, también tiene tres. Con las páginas igual de llenas, tres niveles dan para unos 30 millones de claves, y cuatro, para más de 8 000 millones: la tabla de pedidos podría crecer diez veces antes de necesitar un cuarto nivel.
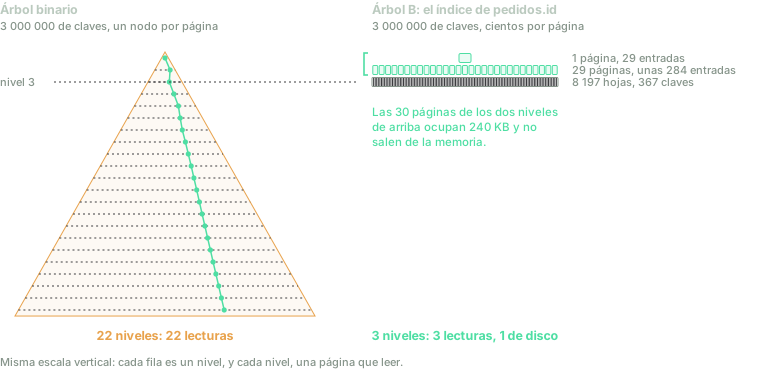
Los mismos 3 millones de claves, a la misma escala: cada fila es un nivel. El árbol binario necesita 22; el índice de Postgres, 3, porque cada página tiene cientos de hijos en lugar de dos.
Además, esas 30 páginas de arriba las usa cada búsqueda, así que no salen de la memoria. Con la caché de Postgres recién vaciada, la primera búsqueda lee cuatro páginas del índice: los tres niveles y una página de control. Entre la décima y la centésima, cada búsqueda lee 1,2 de media, la hoja y poco más; a partir de ahí, menos de una, porque algunas hojas también se quedan. En la práctica, encontrar una clave entre 3 millones cuesta una lectura de disco para el índice y otra para la fila.
Insertar es partir en dos y subir la del medio
Insertar empieza como buscar: bajar hasta la hoja en la que le toca a la clave. Si cabe, se mete en su sitio y ya está, se ha modificado una página. Si no cabe, la hoja se parte en dos mitades, y la clave del medio sube al padre como un poste nuevo entre las dos. Si el padre tampoco tiene sitio, se parte él, y así hacia arriba. Si se parte la raíz, se crea encima una raíz nueva, con un solo poste y dos hijos, y es la única forma que tiene el árbol de crecer en altura.
Esa última frase es la idea entera. Un árbol binario crece por abajo: cada clave nueva cuelga de una hoja, las ramas se alargan, y hay que rotar para recolocarlas. Un árbol B crece por arriba: cuando le falta sitio, añade un nivel encima de todo, y todas las hojas bajan a la vez. No hay que reequilibrarlo porque nunca se desequilibra. La regla del medio lleno también sale sola, porque una página que se parte deja dos mitades.
En Python cabe en treinta líneas:
from bisect import bisect_left

MAX_CLAVES = 4   # en una página de Postgres caben unas 400

class Nodo:
    def __init__(self, claves, hijos=None):
        self.claves = claves        # ordenadas
        self.hijos = hijos or []    # vacío en las hojas; si no, una más que claves

def buscar(nodo, clave):
    while True:
        i = bisect_left(nodo.claves, clave)        # búsqueda binaria dentro de la página
        if i < len(nodo.claves) and nodo.claves[i] == clave:
            return nodo
        if not nodo.hijos:
            return None
        nodo = nodo.hijos[i]                       # otra página: otra lectura

def insertar(raiz, clave):
    partida = _insertar(raiz, clave)
    if partida is None:
        return raiz
    medio, derecha = partida                       # se ha partido la raíz:
    return Nodo([medio], [raiz, derecha])          # el árbol crece por arriba

def _insertar(nodo, clave):
    i = bisect_left(nodo.claves, clave)
    if nodo.hijos:
        partida = _insertar(nodo.hijos[i], clave)
        if partida is None:
            return None
        clave, derecha = partida                   # el hijo se partió: su clave del
        nodo.hijos.insert(i + 1, derecha)          # medio sube a este nodo
    nodo.claves.insert(i, clave)
    if len(nodo.claves) <= MAX_CLAVES:
        return None
    m = len(nodo.claves) // 2                      # no cabe: partir en dos
    derecha = Nodo(nodo.claves[m + 1:], nodo.hijos[m + 1:])
    medio = nodo.claves[m]
    nodo.claves, nodo.hijos = nodo.claves[:m], nodo.hijos[:m + 1]
    return medio, derecha
Con MAX_CLAVES = 4, insertar 10, 20, 30 y 40 llena la raíz, que todavía es la única hoja. El 50
ya no cabe: la hoja se parte en [10, 20] y [40, 50], y el 30 sube a una raíz nueva. El 25, el
35 y el 60 caben en sus hojas sin tocar nada más. El 70 vuelve a llenar la hoja de la derecha, que
se parte en [35, 40] y [60, 70], y el 50 sube a la raíz, que ahora tiene dos postes, [30, 50],
y tres hijos.
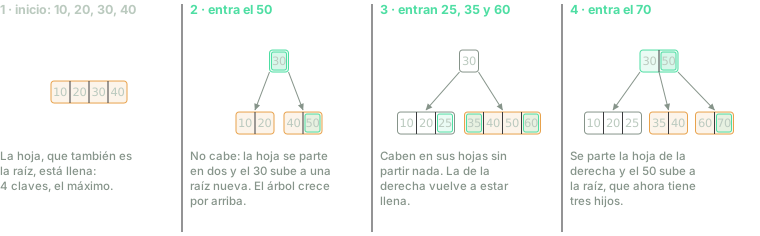
La traza del código de arriba con MAX_CLAVES = 4. En naranja, las páginas que se acaban de
partir o que están llenas; en verde, las claves que acaban de entrar o de subir. Una página sólo
se parte cuando no le cabe una clave, y el árbol sólo gana un nivel cuando se parte la raíz.
Un índice de verdad hace bastantes más cosas: anotar cada página cambiada en el WAL, dejar que otras sesiones lean mientras una página se parte, guardar claves de tamaño variable. Pero la estructura es ésta.
Borrar, en teoría y en Postgres
Borrar sería lo contrario: si una página baja de la mitad, pide claves prestadas a su vecina o se fusiona con ella, y el padre pierde un poste. Postgres no lo hace. Su implementación sólo quita una página del árbol cuando se queda vacía del todo, porque mover claves entre páginas mientras otras sesiones las leen es caro y casi nunca compensa; el hueco lo aprovecha la siguiente inserción que caiga ahí. La regla del medio lleno es una garantía del algoritmo de los libros, no de los índices reales, y la sección del precio vuelve sobre esto.
El árbol rojinegro de la sección anterior, por cierto, también es de Bayer: lo publicó en 1972 como un árbol B de hasta cuatro hijos por nodo escrito con nodos binarios. El árbol binario equilibrado más usado es un árbol B disfrazado.
Contra la lista, el árbol B encuentra una clave en tres páginas, dos de ellas ya en memoria, y casi siempre inserta modificando una sola página, unas pocas cuando parte. Y está ordenado. Pero recorrer un rango en este árbol tiene un problema, y arreglarlo es lo que convierte el árbol B en el árbol B+ que usan de verdad las bases de datos.
El árbol B+: todo en las hojas
En un árbol B, cada clave está una sola vez, en el nivel en el que haya acabado. En la figura del 45, el 30 y el 60 están en la raíz, y el 40 y el 50, en el nivel de en medio. Para encontrar una clave da igual. Para recorrer un rango, no: leer en orden las claves entre 25 y 55 obliga a bajar a una hoja, subir a la raíz a por el 30, bajar a otra hoja a por el 33 y el 36, subir al nivel de en medio a por el 40, y así. El recorrido sube y baja tantas veces como claves del rango haya en los niveles de arriba. Esas páginas suelen estar en memoria, así que no es una catástrofe, pero cada subida es una página más que visitar y, con otras sesiones partiendo páginas a la vez, un camino de vuelta que puede haber cambiado.
El árbol B+ cambia dos cosas. La primera es que todas las claves bajan a las hojas. Los nodos de arriba sólo guardan postes, copias de algunas claves que sirven para decidir por qué hijo bajar, y una misma clave puede estar dos veces, como poste y en su hoja. Cuando una hoja se parte, la primera clave de la mitad derecha no se va de la hoja: lo que sube al padre es una copia. Así, las hojas leídas de izquierda a derecha son la lista completa y ordenada de todas las claves.
La segunda es que cada hoja guarda un enlace a la siguiente (en Postgres, también a la anterior). Recorrer un rango es bajar una vez hasta la primera clave y avanzar de hoja en hoja hasta pasarse de la última, sin volver a subir.
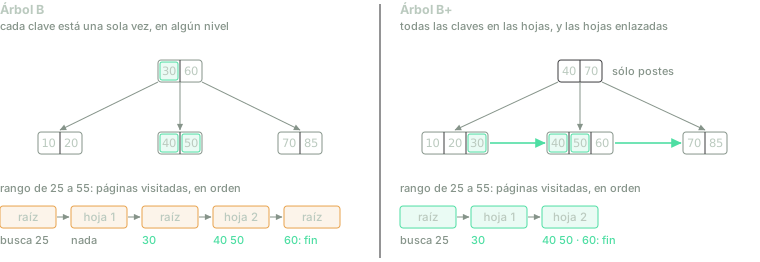
Las mismas ocho claves y el mismo rango, del 25 al 55, en verde. En el árbol B, el recorrido sube y baja por la raíz; en el B+, baja una vez y sigue los enlaces entre hojas.
Es lo que medía la tabla del principio. WHERE id BETWEEN 1234567 AND 1235566 baja por los tres
niveles, avanza por las pocas hojas que contienen los mil id y lee las páginas de la tabla en las
que están esos mil pedidos: 14 en total. ORDER BY id DESC LIMIT 10 baja hasta la última hoja y lee
hacia atrás: cuatro páginas. Y min(id) y max(id) son la primera y la última clave de la lista.
Que los nodos de arriba sólo tengan postes también los hace más anchos. En un índice de Postgres
importa poco, porque sus entradas ya son pequeñas: la clave y la dirección de la fila. Importa mucho
cuando lo que va en el árbol son las filas enteras, que es lo que hace InnoDB con sus tablas, como
se verá en la sección siguiente. En la tabla pedidos de InnoDB, cada página interna tiene unos
1100 postes y cada hoja, unas 340 filas, así que tres niveles dan para unos 400 millones de pedidos.
Si las filas estuviesen repartidas por todos los niveles, como en un árbol B, cada página interna
tendría también unas 340, y tres niveles darían para unos 40 millones.
El precio es que toda búsqueda llega hasta una hoja, también la de una clave que en un árbol B
estaría en la raíz. Son muy pocas. SQLite usa las dos variantes, y eso permite contarlas: sus tablas
son árboles B+, con las filas sólo en las hojas (las 82 páginas internas de su tabla pedidos no
guardan ni un byte de datos), y sus índices son árboles B, con cada entrada una sola vez, en el
nivel que le toque. En su índice sobre cliente_id, sólo 8 663 de los 3 millones de entradas están
en páginas internas, el 0,3 %. Tiene sentido: las filas de una tabla son grandes y conviene dejarlas
abajo, y las entradas de un índice son pequeñas y no compensa duplicarlas como postes.
El árbol B+ no tiene un inventor claro. La reseña que Douglas Comer publicó en 1979 con el título de
The Ubiquitous B-Tree, el árbol B ubicuo, lo describe con
ese nombre y cuenta que IBM ya lo usaba en VSAM (Virtual Storage Access Method), el método de
acceso con el que sustituyó a ISAM en los años setenta. Nueve años después de publicarse, el árbol B
ya estaba en todas partes, y el título de Comer lo decía. Hoy, cuando una base de datos dice «índice
B-tree», casi siempre es un B+: lo son el índice por defecto de Postgres y los de InnoDB y SQL
Server. El índice de pedidos.id de la sección anterior ya lo era. Sus 8 197 hojas tienen los 3
millones de claves, y las 30 páginas de arriba sólo tienen postes.
Lo que hay en la hoja
Un índice dice dónde está cada fila, pero qué guarda exactamente en sus hojas depende de cómo guarda la tabla la base de datos. Hay dos diseños.
Postgres guarda la tabla aparte. Las filas van en sus páginas en el orden en que llegan, donde
haya sitio, sin que ningún índice decida dónde. Cada índice, también el de la clave primaria, es un
árbol B+ separado, y sus hojas guardan, para cada clave, la dirección de la fila: la página de la
tabla y la posición dentro de ella. Buscar por id cuesta las tres páginas del índice y la de la
fila, las cuatro del principio. Buscar los pedidos del cliente 4242 en el índice de cliente_id
cuesta tres páginas del índice y diez de la tabla, porque sus diez pedidos llegaron en fechas
distintas y cada uno está en una página distinta.
InnoDB guarda la tabla dentro del árbol. En MySQL, la tabla es un árbol B+ ordenado por la clave
primaria, y sus hojas no guardan direcciones sino las filas enteras: es lo que se llama un índice
agrupado (clustered index). Buscar por id cuesta tres páginas, y en la tercera ya está la
fila. Los demás índices, los secundarios, no pueden guardar la dirección de la fila, porque en
InnoDB las filas se mueven: cuando una hoja del árbol de la tabla se parte, la mitad de sus filas se
va a otra página, y si los índices secundarios guardasen direcciones, cada partición obligaría a
corregirlos todos. Guardan la clave primaria. Buscar los pedidos del cliente 4242 es bajar por el
índice de cliente_id hasta sus diez entradas, que dan diez id, y bajar otras diez veces por el
árbol de la tabla, tres páginas cada vez.
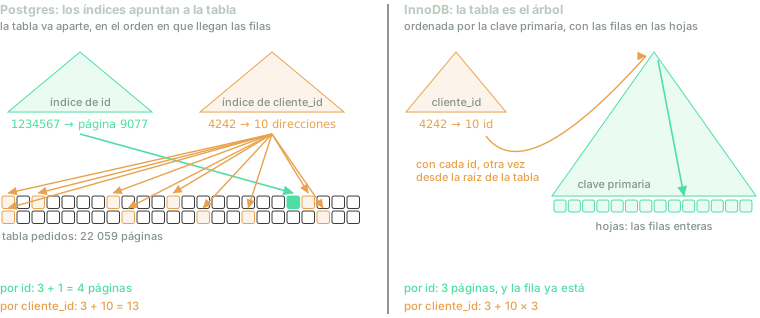
Las mismas dos búsquedas en los dos diseños. En la tabla de Postgres, las posiciones del pedido 1 234 567 y de los diez pedidos del cliente 4242 son las reales, escaladas a 48 casillas.
Contadas una a una, son muchas más páginas que en Postgres: InnoDB anota 50 accesos a páginas para esa consulta. Pero de cada bajada por la tabla, las dos páginas de arriba ya están en memoria, y la que hay que leer del disco es la hoja de cada pedido, igual que en Postgres.
Los dos diseños comparten un atajo: si el índice ya tiene todas las columnas que pide la consulta,
no hace falta ir a la tabla. En InnoDB pasa solo con la clave primaria, que viaja en todos los
índices secundarios: SELECT id FROM pedidos WHERE cliente_id = 4242 se responde sin salir del
índice de cliente_id, con 10 accesos en lugar de 50. En Postgres hay que pedirlo, con un índice
que lleva columnas de más en sus hojas:
CREATE INDEX ON pedidos (cliente_id) INCLUDE (importe);Con él, sumar lo que ha gastado el cliente 4242 lee 4 páginas en lugar de 13. Se llama un índice
cubriente, y no sale gratis: ocupa 90 MB, y el que sólo tiene cliente_id, 24. Tienen las mismas
3 millones de entradas, pero en el segundo Postgres guarda una sola vez cada cliente_id repetido,
con la lista de sus filas, y cada cliente tiene unos quince pedidos. Con columnas incluidas no puede
hacerlo.
Por qué ganó
Con todo lo anterior, la lista de los cuatro trabajos se puede puntuar entera.
Encontrar una clave. Tres páginas, dos de ellas siempre en memoria. La tabla hash lee una menos, pero en la práctica los dos leen del disco una sola página del índice. Y el árbol es el único índice de Postgres que puede garantizar que una clave no se repite.
Recorrer un rango o un orden. 14 páginas contra 22 080, y no sólo para BETWEEN. El mismo
índice resuelve < y >, ORDER BY con LIMIT, min() y max(), LIKE 'abc%' (las claves que
empiezan por «abc» están juntas en el orden) y los cruces de tablas que recorren dos listas
ordenadas a la vez. Un índice sobre varias columnas, ordenado por la primera y, dentro de cada
valor, por la segunda, sirve además para buscar sólo por la primera.
Seguir el ritmo de las escrituras. Una inserción modifica casi siempre una página y, cuando parte, unas pocas, todas en el camino de la raíz a su hoja. No hay que parar a reorganizar el fichero, como en ISAM, ni redistribuir la estructura entera, que es lo que hace una tabla hash sencilla cuando se le queda pequeña.
Aguantar a muchos a la vez, y un apagón. Tiene su propio apartado, justo debajo.
Hay dos razones más que no estaban en la lista y pesan tanto como ella. La primera es que su coste es predecible. Toda búsqueda lee exactamente tantas páginas como niveles tiene el árbol, y el número de niveles crece tan despacio que en la práctica es una constante: para pasar de tres a cuatro, la tabla de pedidos tendría que crecer diez veces. No hay casos malos, ni ramas que se alargan como en un árbol binario sin equilibrar, ni claves que caen todas en el mismo casillero como en un hash con mala suerte. Para una base de datos, que tiene que estimar lo que costará una consulta antes de ejecutarla, eso vale mucho.
La segunda es que no es malo en nada. El hash le gana encontrando una clave, por una página. Una estructura para memoria le gana cuando todo cabe en memoria. Leer la tabla entera le gana cuando hay que leer casi todo. Pero cada una de ellas es inservible en algún trabajo de la lista, y el árbol B+ es bueno en los cuatro. Una base de datos no sabe qué consultas le van a llegar, y por eso elige el índice que nunca es una mala elección.
Muchos a la vez
Que una página se parta mientras otra sesión baja por el árbol es un problema. La sesión lee el padre, que le dice que su clave está en la hoja X, y antes de que llegue a X otra sesión la parte y se lleva la mitad de las claves a una hoja nueva, a su derecha. La primera sesión llega a X y su clave ya no está.
La solución obvia es bloquear: quien va a escribir bloquea las páginas por las que pasa, y quien quiere leerlas espera. Pero todas las operaciones pasan por la raíz, así que bloquearla es poner a todas las sesiones en fila. La solución que usa Postgres es de 1981, de Philip Lehman y S. Bing Yao, y se llama árbol B-link. Añade dos cosas a cada página, no sólo a las hojas: un enlace a su hermana de la derecha y una clave alta, la mayor clave que puede contener. Una sesión que llega a una página y ve que su clave es mayor que la clave alta sabe que la página se ha partido mientras bajaba, y sigue el enlace a la derecha hasta dar con ella. Quien lee no bloquea más que la página que está leyendo, y sólo mientras la lee; quien parte una página bloquea unas pocas, un momento. Es el mismo enlace que el árbol B+ ya tenía entre hojas para recorrer rangos, puesto en todos los niveles.
El apagón lo resuelve el WAL, que anota cada cambio antes de hacerlo. Partir una página toca varias (la que se parte, la nueva y el padre), y la base de datos anota lo suficiente para que una partición que una caída dejó a medias se pueda terminar después. Nada de esto es exclusivo del árbol B. Pero lleva cincuenta años de ingenieros resolviendo exactamente estos problemas sobre él, y eso no lo tiene ninguna alternativa.
Lo que cuesta un árbol B
Nada de esto es gratis, y conviene saber dónde está la factura.
Cada índice es una copia ordenada que hay que mantener. Un INSERT escribe la fila en la tabla
y una entrada en cada índice; en una tabla con cinco índices, escribe en seis sitios. Un índice que
no contesta ninguna consulta de verdad sólo cuesta.
El orden en que llegan las claves decide cuánto cuesta escribirlas. Para medirlo, tres tablas
iguales en las que sólo cambia la clave primaria: un número que crece (bigint), un UUID versión 4
o un UUID versión 7. Un UUID (universally unique identifier) es un identificador de 128 bits
que cualquier programa puede generar sin preguntar a nadie, con una probabilidad despreciable de
repetirse. La versión 4 es aleatoria de principio a fin; la versión
7, de 2024, empieza por la hora en milisegundos, así
que dos UUID v7 seguidos salen en orden. Postgres 18 genera los dos.
| Clave primaria | Cargar 3 millones de filas | Páginas del índice | Hojas llenas al | 20 000 inserciones sin memoria | Páginas leídas del disco |
|---|---|---|---|---|---|
bigint creciente | 16,2 s | 8 228 | 90 % | 0,23 s | 82 |
| UUID v7 | 28,8 s | 11 553 | 90 % | 0,48 s | 85 |
| UUID v4 | 40,1 s | 15 788 | 66 % | 12,2 s | 15 768 |
Con una clave que crece, cada inserción va a la última hoja, siempre la misma, que está en memoria. Cuando se llena, Postgres la parte dejando la de la izquierda llena al 90 %, porque supone que ahí no va a llegar nada más. Con UUID v4, cada inserción cae en una hoja al azar entre más de 15 000. Las hojas se parten por la mitad y se quedan a medio llenar hasta que les toca otra clave. Un resultado clásico, de Andrew Yao en 1978, dice que con inserciones al azar las páginas de un árbol B acaban llenas de media al 69 %, y aquí salen al 66 %. Por eso el mismo índice ocupa un 37 % más con UUID v4 que con UUID v7, que tiene el mismo tamaño de clave.
Mientras todo cabe en memoria, la diferencia es de un 40 % de tiempo. Cuando el índice no cabe, es otra cosa. Las 20 000 inserciones de la quinta columna se hicieron sobre esas mismas tablas, con las dos cachés vacías y Postgres limitado a 160 MB de memoria. Con UUID v7, cada inserción va a la última hoja, que se lee una vez y se queda. Con UUID v4, casi cada una va a una hoja distinta que no está en memoria: una lectura del disco por inserción, y otras 12 488 escrituras para devolver al disco las hojas modificadas cuando hay que hacer sitio. Veinticinco veces más lento. En InnoDB el efecto alcanza a la tabla misma, porque el árbol de la clave primaria es la tabla: con UUID v4, cada fila nueva va a una página al azar de la tabla entera.
Borrar deja huecos. Postgres no fusiona páginas medio vacías. Además, una fila borrada o
actualizada no desaparece en el momento, porque otra transacción puede seguir viéndola: la limpia
más tarde un proceso, VACUUM, que también quita sus entradas de los índices. Un índice de una
tabla con muchos cambios acaba ocupando más de lo que necesita, y a veces hay que reconstruirlo con
REINDEX. Postgres ha ido recortando el problema (desde la versión 13 guarda una sola vez cada
clave repetida, y desde la 14 limpia las entradas muertas de una página antes de partirla), pero no
lo ha hecho desaparecer.
Dónde no gana
El árbol B+ ganó donde lo caro es leer páginas y los datos cambian. Fuera de eso hay estructuras mejores, y las bases de datos las usan.
Cuando se escribe mucho más de lo que se lee. Un árbol LSM (log-structured merge-tree, árbol de fusión estructurado como registro), de 1996, no modifica nada en su sitio. Las escrituras van primero a una estructura ordenada en memoria, a menudo una lista con saltos, y cuando se llena se vuelca al disco de una vez, como un fichero ordenado que ya no se toca. Un proceso de fondo va fusionando esos ficheros en otros más grandes. Escribir es secuencial y barato. Leer una clave puede obligar a mirar varios ficheros, y para no abrirlos todos, cada uno lleva un filtro de Bloom, un resumen que dice con seguridad si una clave no está. RocksDB y LevelDB, dos motores de almacenamiento, y Cassandra, una base de datos distribuida, funcionan así. Facebook pasó en 2017 la base de datos principal de su red social de InnoDB a MyRocks, un MySQL que guarda los datos en RocksDB: ocupó un 62 % menos y necesitó menos de la mitad de servidores. Es el tercer trabajo de la lista comprado con parte del primero.
Cuando todo cabe en memoria. Si las páginas no hay que leerlas del disco, la unidad de coste pasa a ser otra: traer al procesador un trozo de 64 bytes de memoria, que cuesta unos 100 nanosegundos cuando no está en su caché. Las bases de datos en memoria usan árboles de prefijos como el ART de DuckDB, o variantes del propio árbol B con nodos del tamaño de esos 64 bytes. El Bw-tree, que usa SQL Server para sus tablas en memoria, es un árbol B que no bloquea nunca: en lugar de modificar una página, le cuelga una nota con el cambio y actualiza de un golpe el puntero que la señala. La idea del árbol B nunca fue «páginas de 8 KB», sino «nodos del tamaño de lo que se lee de una vez», y eso vale en cualquier nivel de la memoria.
Cuando se lee casi todo. Las bases de datos para análisis, como DuckDB, ClickHouse o BigQuery,
guardan cada columna por separado y responden consultas que recorren millones de filas. Ahí no
compensa mantener un árbol por columna. Guardan, para cada bloque de filas, el mínimo y el máximo de
cada columna, y se saltan los bloques que no pueden contener nada de lo que se pide. Postgres tiene
lo mismo para una columna, el índice BRIN (block range index, índice de rangos de bloques),
que guarda el mínimo y el máximo de cada tramo de 128 páginas. Sobre pedidos.fecha, que está en
orden porque los pedidos se guardaron según llegaban, el BRIN ocupa 3 páginas, y el árbol B, 2 573.
A cambio, los pedidos de un día leen 270 páginas con el BRIN y 26 con el árbol, porque el BRIN sabe
en qué tramo están, pero no en qué fila.
Cuando la pregunta no es de orden. Hay consultas que ningún orden ayuda a contestar: qué documentos contienen una palabra, qué puntos caen dentro de un polígono, qué vectores se parecen más a otro. Postgres tiene un índice para cada una. GIN (generalized inverted index, índice invertido generalizado) guarda, para cada palabra, la lista de filas que la contienen. GiST (generalized search tree, árbol de búsqueda generalizado) es la base de los R-tree para datos espaciales, que son primos del árbol B: equilibrados, con un nodo por página y rectángulos en lugar de postes. Y la extensión pgvector añade HNSW (hierarchical navigable small world), un grafo por capas para encontrar los vectores más parecidos a uno dado, que es lo que usa un buscador semántico.
Los índices aprendidos. En 2018, un artículo de investigadores de Google y del MIT propuso ver un árbol B por lo que hace: una función que recibe una clave y devuelve dónde está. Una función así se puede aprender, con un modelo pequeño entrenado sobre las claves, y en datos que no cambiaban el resultado era más rápido y bastante más pequeño que el árbol. El problema es el tercer trabajo de la lista, porque cada inserción cambia lo que el modelo tiene que predecir. La investigación sigue, y ninguna de las grandes bases de datos ha cambiado su índice por defecto.
En todos los casos cambia una de las dos premisas del principio: o lo caro deja de ser leer páginas, o el índice deja de tener que hacer los cuatro trabajos. Donde se cumplen las dos, que es en casi todas las tablas de casi todas las aplicaciones, sigue el árbol B+.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: un índice no se elige por lo deprisa que encuentra una clave, sino por cuántas páginas lee y cuántas preguntas distintas contesta. La tabla hash encuentra un pedido una página antes que el árbol B+, y no sabe dar los diez siguientes. El árbol binario está ordenado, pero lee una página por clave. El fichero ordenado no se deja modificar. El árbol B+ pone cientos de claves en cada página, crece por arriba para no desequilibrarse nunca y guarda todas las claves en hojas enlazadas en orden. Con eso encuentra, recorre e inserta leyendo tres páginas donde las otras estructuras leen veinte, o veinte mil.
Y si te llevas tres cosas más, que sean prácticas. Las tres salen de lo mismo: un índice es una copia ordenada.
El orden de las columnas de un índice compuesto decide para qué sirve. Un índice sobre
(cliente_id, fecha) está ordenado por cliente y, dentro de cada cliente, por fecha, como una guía
telefónica ordenada por apellido y luego por nombre. Sirve para
WHERE cliente_id = 4242 AND fecha >= '2026-01-01' y para WHERE cliente_id = 4242, porque los dos
piden un tramo seguido del orden. Para WHERE fecha >= '2026-01-01' sola sirve de poco, porque esas
fechas están repartidas por todos los clientes, como los Juan de la guía. Postgres 18 sabe saltar de
un cliente al siguiente dentro del índice, pero sólo compensa cuando hay pocos clientes distintos.
Primero van las columnas que se comparan con =, y al final, la del rango.
El índice no puede usar lo que no es un tramo seguido del orden.
WHERE lower(email) = 'ana@ejemplo.es' no aprovecha un índice sobre email, porque el índice está
ordenado por email, no por lower(email); la solución es indexar la expresión,
CREATE INDEX ON clientes (lower(email)). WHERE email LIKE '%@gmail.com' tampoco: los correos que
acaban igual están repartidos por todo el índice, y no hay orden de principio a fin que los junte.
Elige claves que lleguen en orden. Una clave primaria que crece, o un UUID v7 si necesitas generarla fuera de la base de datos, mantiene las inserciones en la última hoja. Un UUID v4 las reparte por todo el índice: con el índice fuera de memoria, veinticinco veces más lento en esta tienda, y en InnoDB el desorden alcanza a la tabla, que es el propio árbol.
Los discos de 1970 eran mucho más lentos que un SSD, y la memoria, mucho más pequeña. Pero la proporción entre comparar dos claves y leer una página sigue siendo de miles a uno. Mientras lo sea, contar páginas será la forma de entender por qué una consulta es rápida o lenta, y el árbol B+ seguirá siendo el índice que una base de datos crea cuando no se le dice otra cosa.