GRU: la versión simplificada
26 min de lectura
Hasta aquí el bloque ha avanzado preguntando qué le falta a cada red: a la RNN (recurrent neural network) vanilla le faltaba una memoria que sobreviviera a la distancia, y la LSTM (long short-term memory) de la lección anterior, sobre la memoria con compuertas, se la dio. Pero la dio cara: el cuádruple de los pesos de una RNN vanilla y un segundo estado que arrastrar en cada paso. Y la propia lección se despidió sospechando de que una de sus compuertas sobraba. Cuando una arquitectura funciona, la pregunta que queda no es qué le falta, sino qué le sobra.
Simplificar de verdad no es quitar piezas hasta que algo se rompe, sino quitarlas conservando lo que compraban. Y lo que la LSTM compró (lo único que justificaba todo el aparato) era la vía por la que el gradiente vuelve intacto a través de muchos pasos. Cualquier recorte tiene que pasar por ahí: si al fundir compuertas o borrar estados esa vía se pierde, la simplificación ha tirado justo lo que importaba. La GRU (gated recurrent unit) es el recorte que pasa la prueba, y por eso se ha convertido en la alternativa habitual a la LSTM: tres cuartas partes de sus pesos, un solo estado, y (casi siempre, no siempre) el mismo resultado.
El recorte cabe en dos ideas. La primera funde las dos compuertas sospechosas en una: en vez de decidir por separado cuánto se conserva y cuánto se escribe, la GRU usa un solo mando (la compuerta de actualización) que dice cuánto reemplazar, y lo que no reemplaza es lo que conserva. El estado deja de ser una suma que puede crecer sin freno y pasa a ser una mezcla, un punto intermedio entre lo que había y lo que se propone escribir; y una mezcla de cosas acotadas se queda acotada, así que ya no hace falta la compuerta de salida que en la LSTM recortaba el estado antes de enseñarlo.
La segunda idea es una compuerta pequeña y nueva, la compuerta de reset, que no toca la memoria sino el candidato: le deja ignorar el estado anterior cuando lo que hay que escribir ahora no arrastra nada de lo de antes (al empezar una oración nueva, por ejemplo). Con esas dos, y con un único estado que hace de memoria y de salida a la vez, desaparece el segundo vector: ya no hay un estado de celda escondido detrás del que se enseña.
Antes de las fórmulas, vuelve un momento a la LSTM que la GRU simplifica. Recórrela y mira las dos primeras filas (la compuerta de olvido y la de entrada) moverse por separado: ésas son las dos que la GRU va a atar en una.
Conservar y escribir con una sola compuerta
Empieza por la línea que lo cambia todo. La celda de la LSTM sumaba dos términos con compuertas independientes, ; la GRU trabaja directamente sobre el estado oculto (no hay segundo vector) y ata las dos compuertas en una:
con la compuerta de actualización y el candidato, el estado que el paso propone. Coordenada a coordenada es una media ponderada entre lo viejo y lo nuevo: deja igual a (conserva) y lo reemplaza entero por el candidato (escribe). No hay forma de hacer las dos cosas a la vez, y ésa es justo la libertad que la LSTM tenía y la GRU entrega: allí e podían abrirse las dos y acumular. A cambio, una media de números acotados no se desborda, y por eso la GRU enseña el estado tal cual, sin la compuerta de salida ni la que en la LSTM lo recortaban antes de sacarlo.
La compuerta de actualización se calcula como todas las de la lección anterior, una capa sigmoide sobre el token y el estado previo:
con , y : las mismas formas de la recurrencia de la lección sobre la RNN vanilla.
Falta el candidato, y aquí entra la segunda compuerta. En la LSTM el candidato leía siempre el estado anterior completo; la GRU le pone delante un filtro, la compuerta de reset , que decide cuánto de ese estado llega a leer:
El es lo único que distingue este candidato del de una RNN vanilla: con el candidato es la recurrencia de la lección sobre la RNN vanilla tal cual, y con se calcula sólo con el token, como si la secuencia empezara ahí. Conviene no confundir las dos compuertas: decide si el estado se actualiza, decide qué mira el candidato para proponer. Una gobierna la memoria; la otra, el candidato.
Las tres piezas juntas, con por lo mismo que en la RNN y la LSTM:
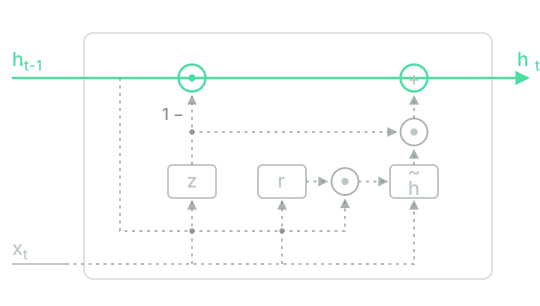
Tres piezas (dos compuertas y un candidato), cada una con la forma exacta de la recurrencia de la lección sobre la RNN vanilla: seis matrices y tres sesgos, pesos. Frente a los cuatro grupos de la LSTM, tres cuartas partes; y como allí, no aparece en ninguna de las formas, así que la GRU lee cualquier longitud con el mismo juego de pesos.
Por qué la vía de vuelta sobrevive al recorte
Toda la lección pende de una comprobación: que la vía por la que el gradiente vuelve (la que la LSTM compró y la lección sobre el gradiente que se desvanece explicó por qué hacía falta) siga en pie con un estado en lugar de dos. Mira la última línea coordenada a coordenada, que es donde se ve lo que el significa:
La coordenada del estado nuevo depende de la del viejo y de ninguna otra por esta vía: no hay matriz que las mezcle. Derivando por el camino directo, y dejando quietas las compuertas y el candidato (volveré sobre eso),
un número, no una matriz. Encadénalo hacia atrás hasta un paso lejano , igual que la lección sobre el gradiente que se desvanece encadenaba la recurrencia, y lo que llega por la vía directa es un producto de esos números:
Es, letra por letra, el de la LSTM con en el sitio de : la compuerta de actualización cerrada () hace de compuerta de olvido abierta. Y vale lo mismo que allí ( es alcanzable y estable, porque una sigmoide saturada se queda plana en el extremo), así que una coordenada que la red aprenda a no actualizar multiplica por tantos pasos como haga falta. Frente al de la lección sobre el gradiente que se desvanece, la base ha dejado de ser una propiedad de una matriz compartida por todo para ser un número por coordenada y por paso que la red calcula.
Ver qué se ha dejado fuera al «dejar quietas las compuertas»
, y se calculan a partir de , así que la derivada completa suma, al del camino directo, los caminos que pasan por las dos compuertas y por el candidato. Todos ellos cruzan una y una máscara de activación, y se desvanecen igual que los de la lección sobre el gradiente que se desvanece.
Que se desvanezcan no rompe nada, y es la misma lectura que en la LSTM. Esos caminos ajustan cómo se decide en cada paso, y una decisión de este paso se toma con lo que hay cerca; el que tiene que llegar de lejos es el de la vía directa, y ése no cruza ninguna matriz. El recorte no elimina el producto de la lección sobre el gradiente que se desvanece: lo aparta del camino largo y lo deja en los cortos.
Dos concesiones cierran la cuenta, las mismas que en la LSTM. Si la red aprende alrededor de , el producto se hunde igual que en la RNN, sólo que porque la red lo decide y no porque la arquitectura lo imponga. Y la explosión sigue siendo posible por los caminos del recuadro de arriba, así que la GRU se entrena con recorte del gradiente igual que todo lo anterior. La vía aditiva no regala una garantía; hace alcanzable una opción que antes no lo era.
La GRU, paso a paso, en NumPy
Una celda. Transcribe el recuadro de cuatro líneas y lo corre sobre una secuencia corta con dos sesgos distintos de la compuerta de actualización, para ver cuánto de llega a por la vía directa.
Los pesos me los da un generador con semilla fija y no están entrenados, así que las compuertas todavía no significan nada. Lo que sí he puesto a mano es el sesgo : recuerda que conservar es , así que un sesgo negativo es lo que empuja a la red a recordar (el reflejo del positivo de la LSTM). Mira la última línea de cada bloque.
d_model, d_h, T = 4, 3, 6
X = np.random.default_rng(1).normal(size=(T, d_model)) * 0.5
def sigmoide(z):
return 1.0 / (1.0 + np.exp(-z))
def pesos(sesgo_z):
rng = np.random.default_rng(0) # los mismos pesos en los dos casos
return {k: (rng.normal(size=(d_h, d_model)) * 0.5,
rng.normal(size=(d_h, d_h)) * 0.5,
np.full(d_h, b))
for k, b in [("z", sesgo_z), ("r", 0.0), ("h", 0.0)]}
def paso(P, h, x):
def entra(k, estado):
Wx, Wh, b = P[k]
return Wx @ x + Wh @ estado + b
z = sigmoide(entra("z", h))
r = sigmoide(entra("r", h))
cand = np.tanh(entra("h", r * h)) # el candidato lee r (*) h_{t-1}
h = (1 - z) * h + z * cand # la via aditiva, atada
return h, z, r
for sesgo in [0.0, -3.0]:
P = pesos(sesgo)
h, guardados = np.zeros(d_h), []
print("b_z = %.0f" % sesgo)
print(" t z_t r_t h_t")
for t, x in enumerate(X, 1):
h, z, r = paso(P, h, x)
guardados.append(1 - z)
print(" %d %s %s %s" % (t, np.round(z, 2), np.round(r, 2), np.round(h, 2)))
print(" de h_1 sobrevive en h_6:", np.round(np.prod(guardados[1:], axis=0), 3))
La primera ejecución descarga el intérprete de Python (~15 MB). Después queda en la caché del navegador y se reutiliza en todas las lecciones.
Las dos compuertas viven en , y cada coordenada recibe un valor propio (donde dos se imprimen iguales, difieren más allá del segundo decimal). Compara los dos bloques por la última línea. Con la de actualización ronda , se reemplaza medio estado en cada paso y de llega a en torno a un ; con ronda , casi no se actualiza nada, y sobrevive un , con los mismos pesos y la misma secuencia. De ahí la costumbre de inicializar negativo, por lo mismo que positivo en la LSTM: sale más barato que la red aprenda a escribir que aprenda a recordar. Y fíjate en el precio del atajo: con el estado casi no se mueve ( se queda en centésimas), porque conservar y escribir son el mismo mando, y pedirle que conserve es pedirle que apenas escriba.
Comprueba tu intuición
Cuatro preguntas: qué ata y qué suelta la compuerta de actualización, qué hace la de reset sin tocar la memoria, cuánto cuesta la arquitectura, y qué se lleva la GRU de la LSTM y qué deja por el camino.
¿Qué gana y qué pierde la GRU al sustituir las compuertas de olvido y de entrada de la LSTM por una sola, la de actualización ?
La compuerta de reset multiplica al estado anterior dentro del candidato: . Con , ¿qué ocurre?
Una GRU con un estado de coordenadas sobre embeddings de , las mismas dimensiones de la LSTM de la lección anterior. ¿Cuántos pesos suman sus seis matrices y sus tres sesgos?
Se acepta un margen de ±0.
Marca todo lo que sea cierto de la GRU frente a la LSTM.
Marca todas las opciones correctas. Se corrige todo o nada: no hay puntuación parcial.
Y el paso completo escrito por ti, que es la recurrencia de la RNN vanilla envuelta en dos compuertas.
Escribe un paso de GRU: paso_gru(h, x, P) recibe el estado anterior, el vector del token de
turno, y un diccionario P con los pesos de las tres piezas (P["z"], P["r"] y P["h"],
cada una la tripleta (Wx, Wh, b)). Devuelve h_nuevo.
Las dos compuertas son sigmoides sobre el token y el estado anterior; el candidato es una que lee en lugar de a secas, y el estado nuevo es la mezcla . Calcula las dos compuertas con el estado que entra, no con el que vas a devolver. No escribas en los arrays que recibes.
La primera comprobación descarga el intérprete de Python (~15 MB); después queda en la caché del navegador. Este desafío se resuelve mejor con un teclado físico: en el móvil puedes leerlo y volver luego.
Con la GRU y la LSTM, el bloque tiene ya dos maneras de darle memoria a una red, y las dos descansan en el mismo hallazgo: una vía por la que el estado avanza sumándose, sin cruzar una matriz, que es lo único que deja al gradiente volver desde lejos. Pero saber construir la celda no es lo mismo que haber construido algo con ella. En todo el bloque no ha corrido todavía una red que lea un texto de principio a fin y produzca lenguaje propio: se ha derivado la maquinaria sin encenderla.
Encenderla es la siguiente lección, el proyecto de un modelo de lenguaje a nivel de carácter. Junta la RNN vanilla y la BPTT (backpropagation through time) en una red que se entrena sobre unos pocos miles de caracteres y después genera, carácter a carácter, un texto nuevo. Saldrá malo (lo diré sin adornos cuando salga), correrá en el navegador en unos segundos, y será la primera vez en el curso que algo escribe.
Para profundizar2 fuentes · 2 papers
De dónde sale lo de esta lección, y dónde seguir si quieres más. Nada de aquí hace falta para continuar el curso.
- Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation
Su §2.3 introduce las compuertas de reset y de actualización que montas aquí. Ojo al signo: su z conserva y tu z escribe, así que donde tú pones z él pone 1-z. El nombre «GRU» aún no aparece, y el grueso del artículo va de traducción.
- Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling
Aquí se fija el nombre «GRU» y la convención de la lección, con z que escribe. Compara GRU y LSTM en música y voz y respalda tu «casi siempre, no siempre»: quedan parejas y el artículo no se moja sobre cuál gana. No toca texto.