Entrenar un mini-GPT en NumPy
30 min read
Un mini-GPT recién inicializado reparte su apuesta casi por igual entre las 512 entradas del vocabulario, y la pérdida de la lección sobre el modelo de lenguaje causal le cobra por eso en cada posición. El que cargan las celdas de este bloque paga sobre páginas que nunca vio. Los dos leen los ids del tokenizador de la lección sobre BPE y son la misma red, con números cada uno. Lo único que los separa es el valor de esos números.
Entre uno y otro hay pasos de entrenamiento, y esta lección escribe el bucle que los dio. Es el del curso anterior (la pérdida, su gradiente, un paso en contra, repetir) con tres cambios, los mismos que llevan todos los modelos grandes. Cada paso mira unas pocas ventanas sacadas al azar, no el corpus entero. El gradiente no va tal cual al paso: pasa antes por AdamW. Y sube al principio y baja al final. El primero lo derivamos; los otros dos quedan enunciados, con sus razones.
El primero es una cuestión de coste. La parte del corpus con la que se entrenó el checkpoint tiene tokens, y una ventana de tokens puede empezar en casi cualquiera de ellos: unas ventanas solapadas. El gradiente exacto de su pérdida media exige la ida y la vuelta de todas, unos ocho millones de tokens: en el navegador, a algo menos de un milisegundo por token, casi dos horas por paso. Un paso del checkpoint miraba ventanas de tokens sacadas al azar, casi cuatro mil veces menos.
Es una encuesta: no le preguntas a todo el país sino a mil personas al azar, y la respuesta sale con ruido pero sin sesgo, con un ruido que baja al crecer la muestra, aunque despacio. La primera sección demuestra las tres cosas.
El segundo cambio lo anunció el curso anterior sin llegar a hacerlo. En su lección sobre el descenso de gradiente, una sola no podía servir a la vez para una dirección empinada y otra casi plana, y los arreglos, momentum y Adam, quedaron fuera. En un batch del mini-GPT hay coordenadas del gradiente miles de veces más pequeñas que otras. AdamW le da a cada parámetro su propia escala, de modo que ninguno se mueve mucho más que por paso, sea cual sea el tamaño de su gradiente.
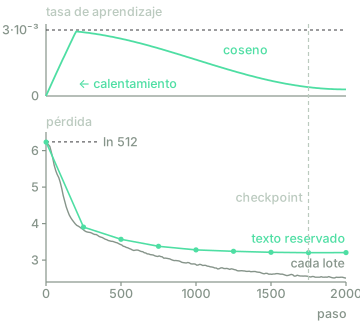
El tercero, la que sube y baja, se ve en el entrenamiento del checkpoint.
Un batch al azar apunta, de media, adonde apunta el corpus
Fijemos la parte de entrenamiento del corpus y llamemos a la pérdida de la lección sobre el modelo causal en la ventana de tokens que empieza en la posición : la media de sus valores de . La pérdida que entrenar quiere bajar es la media de todas,
donde se elige al azar, con la misma probabilidad para cada posición en la que cabe una ventana, y es la media sobre ese azar.
Un batch de tamaño son posiciones sacadas así, cada una por su cuenta, y su pérdida es la media de las suyas:
En el código, ventanas(ids, B, T, rng) devuelve X e Y, dos matrices de ids de forma
, la segunda corrida una posición, y la red devuelve logits de forma
. El gradiente de es el de siempre, el softmax menos el one-hot en cada fila y después la vuelta de
la lección sobre backpropagation, y
perdida devuelve las dos cosas, con los gradientes en un diccionario de las mismas claves y formas
que los pesos.
Dos propiedades hacen que sirva. La primera es que no tiene sesgo. Cada sale del mismo sorteo que , así que la media de es para cada , y la media de números con esa media tiene esa media. El gradiente es lineal y atraviesa la media igual que atraviesa una suma:
Llamemos al lado derecho, el gradiente que costaría dos horas, y al de dentro de la media, el del batch: dos vectores con una coordenada por parámetro. Un paso con va, de media, adonde iría un paso con .
La segunda es que su ruido baja como . Lo que se aleja de , medido como la media del cuadrado de la distancia, es
el ruido de una sola ventana dividido entre .
Ver de dónde sale la división entre B
es la media de las desviaciones , y el cuadrado de su norma es
Toma la media término a término. Si , las dos posiciones se sortearon por separado, así que la media del producto es el producto de las medias, y cada una de ellas vale . Los términos cruzados se anulan, que es la misma cuenta con la que la lección sobre el producto interno escalado sumaba productos independientes. Quedan los términos con , cada uno de media , divididos entre .
El precio está en la raíz. El tamaño típico del error baja como y el coste del paso crece como : la mitad de ruido cuesta cuatro veces más tokens. Y las ventanas se sacan al azar, no en orden como en el modelo de lenguaje de caracteres, porque las dos cuentas necesitan que cada salga del mismo sorteo que . En orden, el gradiente de cada paso sería el de una página de la novela, y el modelo iría detrás del argumento.
Un paso de AdamW, a la tasa que toca
Numeremos los pasos y llamemos a los parámetros después del paso (el curso anterior escribía , pero aquí ya es la posición dentro de la ventana). El paso saca un batch, calcula su gradiente y hace con él tres cosas, en este orden.
Primero, el recorte de la lección sobre el gradiente que se desvanece: si , lo dividimos entre su norma. Aquí la norma es la de las coordenadas juntas y no la de cada grupo de pesos, así que el recorte encoge el paso sin torcer su dirección.
Después, AdamW. Guarda dos medias móviles, una del gradiente y otra de su cuadrado coordenada a coordenada, que empiezan en cero y en cada paso le dan un peso al gradiente nuevo y a lo que ya llevaban:
con . (El artículo de Adam y minigpt.py llaman
y , beta1 y beta2, a lo que aquí es y : la queda
reservada para el bloque 2.) Con ellas mueve los parámetros, coordenada a coordenada:
El mini-GPT usa , y , que sólo evita dividir
entre cero. Y : he entrenado el checkpoint sin decaimiento de pesos, así que su
Adam es AdamW con la W apagada. Escribirla es el reto de esta lección.
La fórmula queda enunciada (el artículo sobre AdamW de «Para profundizar», al pie, la deriva), pero tres cosas se leen en ella. La división entre deshace el arranque en cero: en el primer paso, es y es su cuadrado, así que el cociente vale el signo del gradiente, coordenada a coordenada. El primer paso mueve entero cada parámetro cuyo gradiente no sea cero, sea éste de o de .
Después, el cociente compara la media reciente del gradiente con la raíz de la media reciente de su cuadrado. Si el gradiente insiste en un signo, las dos se parecen y el cociente ronda ; si su signo es ruido, se acerca a . Cada parámetro se mueve, como mucho, del orden de por paso: la única del curso anterior, con una escala propia para cada coordenada.
Y va fuera del cociente: cada peso se encoge la misma fracción, , tenga la historia de gradientes que tenga. Eso es el decaimiento de pesos desacoplado, la W (weight decay) que Loshchilov y Hutter le añadieron a Adam. Sumado a , pasaría por la división y encogería menos a los pesos que más se mueven.
Queda . El checkpoint la saca de un calendario de dos tramos, un calentamiento (warm-up) lineal durante pasos y un descenso en coseno hasta la décima parte,
con , y : la curva de arriba de la figura.
El calentamiento sale de la primera lectura de la fórmula. Mientras y llevan uno o dos gradientes, cada parámetro da un paso de casi en la dirección del signo de un gradiente lleno de ruido: pasos a ciegas del mismo tamaño, que sólo son pequeños si lo es.
El descenso sale de la primera sección. Cerca del final, con la pérdida casi plana, es pequeño pero el ruido del batch no se va, y el gradiente de cada paso es casi todo ruido. Con fija, el modelo tiembla alrededor del mínimo a una distancia que crece con ; bajarla al final lo deja asentarse.
El mini-GPT, entrenado delante de ti
Las tres celdas corren sobre el mini-GPT: minigpt.py, el fichero de NumPy que produjo el
checkpoint, y minigpt.json, sus pesos. Es la columna del
proyecto del Transformer en pequeño
(dos bloques, cuatro cabezas, ) más perdida, que hace la ida, la pérdida y
la vuelta, y Adam.
La primera carga el tokenizador, el modelo y el corpus, aparta el último 10 %, el texto reservado que el checkpoint no vio nunca, y saca un batch de cuatro ventanas de ocho tokens para que veas las formas. Después mide sobre él el checkpoint y la misma red con los pesos del paso 0.
import numpy as np
from pyodide.http import open_url
exec(open_url("/courses/llm-agents/bpe.py").read()) # codificar, vocabulario, quitar_cabecera
exec(open_url("/courses/llm-agents/minigpt.py").read()) # MiniGPT, ventanas, Adam
F = [tuple(par) for par in json.load(open_url("/courses/llm-agents/bpe-merges.json"))]
V = vocabulario(F)
ids = np.array(codificar(quitar_cabecera(open_url("/courses/llm-agents/corpus.txt").read()), F))
n_val = len(ids) // 10 # el último 10 %: el checkpoint no lo vio
entren, val = ids[:-n_val], ids[-n_val:]
print(len(entren), "tokens de entrenamiento y", len(val), "reservados")
X, Y = ventanas(entren, 4, 8, np.random.default_rng(0)) # B = 4 ventanas de T = 8 tokens, y uno más
print("X", X.shape, " Y", Y.shape)
print("X[0] =", [V[i].decode("utf-8", "replace") for i in X[0]])
print("Y[0] =", [V[i].decode("utf-8", "replace") for i in Y[0]])
pesos = open_url("/courses/llm-agents/minigpt.json").read()
modelo = MiniGPT.cargar(pesos)
nuevo = MiniGPT(semilla=0) # la misma red, con los pesos del paso 0
Xv, Yv = ventanas(val, 8, 64, np.random.default_rng(1)) # ocho ventanas del texto reservado
print("%d parámetros ln 512 = %.3f" % (modelo.n_parametros(), np.log(512)))
print("pérdida sin entrenar: %.3f" % nuevo.perdida(Xv, Yv)[0])
print("pérdida del checkpoint: %.3f" % modelo.perdida(Xv, Yv)[0])
The first run downloads the Python interpreter (~15 MB). After that it stays in the browser cache and is reused across every lesson.
La primera fila de X es Anduvieron b en ocho tokens, y la de Y, la misma corrida uno,
acaba en re. La red sin entrenar paga , casi : con pesos de tamaño
los logits salen casi iguales y el softmax reparte por igual. El checkpoint paga .
Entre los dos números están los pasos de la figura.
La segunda pone a prueba el . Para , y ventanas de ocho tokens, saca ocho batches independientes y mide cuánto se alejan sus gradientes de la media de los ocho: una estimación de . Si la sección tiene razón, por el ruido no cambia.
def gradiente(B, rng, T=8):
"""El gradiente de la pérdida de un batch de B ventanas: sus 136 448 números, en fila."""
X, Y = ventanas(entren, B, T, rng)
_, g = modelo.perdida(X, Y)
return np.concatenate([v.ravel() for v in g.values()])
rng = np.random.default_rng(2)
for B in [1, 4, 16]:
G = np.array([gradiente(B, rng) for _ in range(8)]) # ocho batches independientes, uno por fila
# estima E||g_batch - g||^2; ddof=1 porque la media también sale de estos ocho
ruido = G.var(axis=0, ddof=1).sum()
print("B = %2d ruido %6.1f B · ruido %6.1f" % (B, ruido, B * ruido))
The first run downloads the Python interpreter (~15 MB). After that it stays in the browser cache and is reused across every lesson.
El ruido cae de a y a , catorce veces menos con dieciséis veces más ventanas, y por el ruido se queda entre y . Las estimaciones tienen su propio ruido; cambia la semilla y la constante sigue ahí.
La tercera sigue entrenando, sobre una copia del checkpoint y con un Adam nuevo: el checkpoint
guarda pero no ni , así que el calentamiento vuelve a hacer falta.
Entrena sobre los últimos tokens del texto reservado, las últimas páginas de Marianela,
con una sola ventana de tokens por paso: el batch más ruidoso, pero el que cabe en el
navegador. El calendario es el del checkpoint en pequeño, con , más o
menos donde el suyo lo dejó ( en el paso 1 750). En un dispositivo lento, la celda
se detiene antes de que el navegador la corte, y dice dónde.
import time
eta_max, S_cal, S = 5e-4, 50, 200
def tasa(s):
"""El calendario del checkpoint en pequeño: calentamiento lineal y coseno hasta la décima parte."""
return eta_max * min(1, s / S_cal) * (0.1 + 0.9 * (1 + np.cos(np.pi * s / S)) / 2)
alumno = MiniGPT.cargar(pesos) # una copia: el checkpoint no se toca
opt = Adam(alumno.p) # m y v en cero: el checkpoint no los guarda
cola = val[-3000:] # las últimas páginas, que no vio nunca
Xp, Yp = ventanas(cola, 8, 16, np.random.default_rng(1)) # ocho ventanas fijas de esas páginas
rng, t0 = np.random.default_rng(0), time.time()
print("paso 0 pérdida %.3f" % alumno.perdida(Xp, Yp)[0])
for s in range(1, S + 1):
X, Y = ventanas(cola, 1, 16, rng) # B = 1: lo que cabe en el navegador
_, g = alumno.perdida(X, Y)
norma = np.sqrt(sum((v ** 2).sum() for v in g.values()))
if norma > 1: # el recorte, sobre las 136 448 a la vez
g = {k: v / norma for k, v in g.items()}
opt.paso(alumno.p, g, tasa(s))
if s % 25 == 0:
print("paso %3d pérdida %.3f eta %.1e" % (s, alumno.perdida(Xp, Yp)[0], tasa(s)))
if time.time() - t0 > 8: # el navegador corta a los 10 s
print("tiempo agotado en el paso", s)
break
The first run downloads the Python interpreter (~15 MB). After that it stays in the browser cache and is reused across every lesson.
La pérdida sobre esas páginas baja de a , pero no en cada medida: sube en el paso 50, y otra vez en el 100 y el 125. Con una ventana por paso, cada es casi todo ruido y el modelo avanza dando tumbos. Y lo que baja es la pérdida sobre las páginas con las que entrena: si eso es aprender español o aprenderse esas páginas lo mide la lección sobre perplejidad, más adelante en el bloque.
Ahora quítale el calentamiento: pon eta_max, S_cal, S = 3e-3, 1, 200, la tasa máxima del
checkpoint sin calentar, y vuelve a ejecutarla. En 25 pasos la pérdida salta de a ,
porque el primer paso mueve cada parámetro en la dirección de un solo gradiente
lleno de ruido. Con S_cal = 50 el salto se retrasa, no desaparece: llega hacia el paso 75, a
, justo después de que la tasa toque su máximo. El calentamiento protege el arranque y nada
más. El checkpoint salió del final de su calendario, con la tasa en la décima parte, y reanudarlo a
la máxima lo saca de donde estaba.
Comprueba tu intuición
Cuatro preguntas sobre el batch y el primer paso de Adam, y un reto: escribir AdamW.
Con ids un array largo de ids, como el corpus de la primera celda, y ventanas la de minigpt.py, ¿qué imprime esto?
X, Y = ventanas(ids, 4, 16, np.random.default_rng(0))
print(X.shape, Y.shape, (X[:, 1:] == Y[:, :-1]).all())
Pasas de a ventanas por paso, con la misma . ¿Qué les pasa al tamaño típico del error del gradiente, , y al coste de cada paso?
El checkpoint dio pasos con batches de ventanas de tokens, sobre los tokens de entrenamiento. ¿Cuántas veces, de media, le tocó predecir cada token? Redondea a un decimal.
A margin of ±0.3 is accepted.
Cargas el checkpoint, creas un Adam nuevo y das un solo paso con , sin calentamiento. ¿Qué le pasa a un parámetro cuyo gradiente, en ese paso, no es cero?
Escribe el método paso de AdamW: un paso de la fórmula de la sección, coordenada a
coordenada, sobre un diccionario de pesos como modelo.p. En cada llamada suma uno a
self.s, actualiza las dos medias móviles de cada peso, self.m[k] y self.v[k], con
su gradiente g[k], y resta a p[k], en su sitio, lo que dice la fórmula: con la eta
de esa llamada y el decaimiento self.lam fuera del cociente. Con lam = 0 tiene
que dar lo mismo que el Adam de minigpt.py.
The first run downloads the Python interpreter (~15 MB); after that it stays in the browser cache. This challenge is much easier to solve on a physical keyboard: on a phone, read it and come back later.
El mini-GPT ya se entrena, y lo que sale de él es lo mismo que salía en la tabla a mano de la lección sobre el modelo de lenguaje causal: en cada posición, una distribución sobre las 512 entradas. La pérdida sólo le pregunta cuánto apostó por el token que de verdad venía; nunca le pide que elija uno. Para escribir texto hay que elegir, token a token, y el modelo no dice cómo.
Ése es el asunto de la lección siguiente, sobre el muestreo: quedarse siempre con la entrada más probable, que en el mini-GPT acaba repitiendo no, no, no, o sortear entre las posibles con una temperatura, un top-k o un top-p, y qué parte de la distribución tira cada uno.
Further reading3 sources · 2 papers, 1 article
Where this lesson comes from, and where to go next. None of it is needed to carry on with the course.
- Por qué AdamW para entrenar modelos de lenguaje, y qué está cambiando
El artículo de este sitio que deriva lo que la lección enuncia: de dónde salen las dos medias de Adam, por qué la W va fuera del cociente y qué justifica el calentamiento y el descenso de la tasa.
- Decoupled Weight Decay Regularization
El artículo de la W: por qué, con Adam, sumar el decaimiento al gradiente no es lo mismo que aplicarlo fuera. Su algoritmo 2 pone las dos versiones una al lado de la otra, y la segunda es el reto de esta lección.
- Language Models are Few-Shot Learners
El artículo de GPT-3. Su apéndice B es la receta de esta lección a escala: AdamW, recorte a norma 1, calentamiento lineal y coseno hasta el 10 % de la tasa, para un modelo de 175 000 millones de parámetros.