 Por Gustavo Torres
En junio de 2023, la clasificación pública de modelos abiertos de Hugging Face, la mayor plataforma para compartir modelos de lenguaje, daba a LLaMA 65B un 48,8 % en MMLU (Massive Multitask Language Understanding, comprensión del lenguaje en muchas tareas), un examen tipo test de 14 042 preguntas sobre 57 materias. LLaMA 65B era el modelo grande que Meta había publicado en febrero, y el número es su tamaño: 65 000 millones de parámetros (la B es de billion, mil millones en inglés). El artículo de Meta le daba bastante más, y la diferencia era demasiado grande para atribuirla a la casualidad. Hugging Face investigó por qué y encontró tres programas que decían corregir el mismo examen. Con el mismo modelo y las mismas preguntas, el código original de MMLU daba un 63,6 %; el de HELM (Holistic Evaluation of Language Models, el banco de pruebas de la Universidad de Stanford), un 63,7 %, y el LM Evaluation Harness, la herramienta para evaluar modelos de lenguaje (language models, LM) del grupo de investigación abierta EleutherAI, que era la que usaba la clasificación, un 48,8 %.
No cambiaba sólo la nota: cambiaba el orden. Con el Harness, Falcon 40B, el modelo del Technology Innovation Institute de Abu Dabi, quedaba por delante de LLaMA 65B, con un 52,7 % frente a un 48,8 %. Con el código original quedaba tercero, también por detrás de LLaMA 30B. Y los modelos más débiles, que con el código original apenas pasaban del 25 % que da contestar al azar, ganaban casi diez puntos con el Harness.
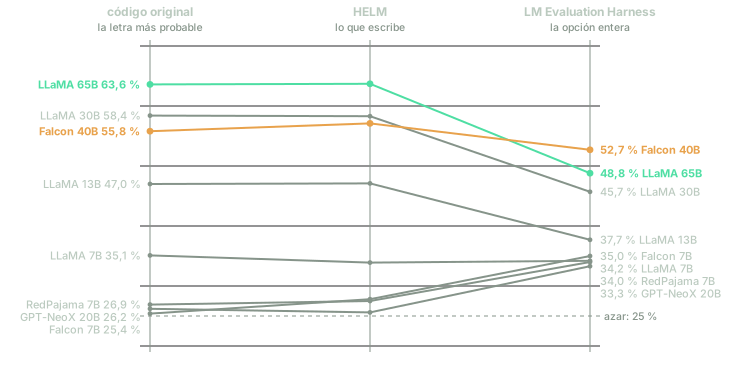
Ocho modelos, el mismo examen y tres programas que lo corrigen, según Hugging Face en junio de 2023. Cambia la nota de cada modelo y cambia quién va primero.
Un examen tipo test parece el caso en que evaluar un modelo de lenguaje está resuelto. Lo difícil de evaluar lo que escribe un modelo es decidir si una respuesta está bien, porque casi nunca hay una sola respuesta correcta, y para eso hacen falta otros jueces: un programa que compruebe, una persona, otro modelo. En un examen tipo test, en cambio, cada pregunta tiene una clave, una letra, y corregir es comparar letras. Por eso los bancos de pruebas (benchmarks, colecciones fijas de preguntas con las que se compara a los modelos) de respuesta cerrada son la forma más común de comparar modelos, y sus cifras las que abren la ficha de cada modelo nuevo.
Y aun así, la nota depende de cuatro decisiones que no se publican junto a ella: cómo se lee la respuesta, cómo se hace la pregunta, qué preguntas se usan (y si el modelo ya las había visto) y cuántas son. Cualquiera de ellas mueve el resultado más que la distancia entre los modelos que se comparan. Este artículo las recorre una a una con preguntas reales de MMLU y dos modelos pequeños medidos en un portátil, y termina con lo que conviene preguntar antes de fiarse de la cifra de la ficha de un modelo. Es el segundo de una serie sobre cómo se evalúan los modelos de lenguaje; el primero presenta los distintos jueces, pero no hace falta haberlo leído.
Qué hay dentro de un banco de pruebas
Un banco de pruebas con respuesta fija tiene cuatro piezas. Las preguntas. La clave, la respuesta correcta de cada una. Una regla de corrección, que dice cómo se saca la respuesta del modelo y cuándo coincide con la clave. Y una forma de promediar, que convierte miles de aciertos y fallos en un número. Las dos primeras son el examen, y se publican. Las dos últimas son el instrumento de medida, y casi nunca aparecen junto a la nota.
MMLU es el ejemplo de manual. Lo publicó en 2020 un grupo encabezado por Dan Hendrycks, de la Universidad de California en Berkeley: 14 042 preguntas de prueba con cuatro opciones cada una, repartidas en 57 materias que van del álgebra abstracta a la virología, con entre 100 y 1 534 preguntas por materia. Ya el promedio tiene dos versiones: sobre las 14 042 preguntas, donde el derecho (professional law), con sus 1 534, pesa quince veces más que el álgebra abstracta, o sobre las 57 materias, donde todas pesan igual. Cada materia trae además cinco preguntas resueltas que no cuentan para la nota y sirven de ejemplo. Así ve el modelo una pregunta, con los cinco ejemplos delante:
The following are multiple choice questions (with answers) about high school geography.

The rate of natural increase of a population is found by subtracting the
A. crude death rate from the crude birth date.
B. crude birth rate from the crude death rate.
C. doubling time from the crude birth rate.
D. fertility rate from the crude death rate.
Answer: A

[… cuatro preguntas resueltas más, con el mismo formato …]

What family do most European languages belong to?
A. Ural-Altaic
B. Basque
C. Indo-European
D. Phoenician
Answer:
Los cinco ejemplos resueltos no enseñan la materia; enseñan el formato. Es el aprendizaje en
contexto: el modelo ve cinco veces el patrón pregunta,
opciones, Answer: y una letra, y lo continúa. Por eso se dice que MMLU se evalúa con cinco
ejemplos (5-shot); sin ellos sería 0-shot.
El texto termina en Answer:, y ahí acaba lo que el examen fija. El modelo todavía no ha contestado
nada, porque un modelo de lenguaje no contesta: continúa texto. Para la posición siguiente da una
probabilidad a cada una de las piezas de su vocabulario, los tokens (palabras, trozos de palabra
o signos sueltos). Leer la respuesta es decidir qué hacer con esa lista de probabilidades, y no hay
una sola forma de hacerlo.
Para verlo con números que cualquiera pueda repetir he medido dos modelos pequeños y abiertos: SmolLM2-360M, de Hugging Face, con 360 millones de parámetros y un vocabulario de 49 152 tokens, y Qwen2.5-0.5B, de la empresa china Alibaba, con 500 millones de parámetros y 151 665 tokens. Son modelos base, sin ajustar para conversar, que es lo que MMLU tenía en mente. Las medidas usan 570 preguntas de MMLU, diez de cada materia elegidas al azar con una semilla fija, siempre las mismas y siempre con los mismos cinco ejemplos. El programa descarga los modelos y las preguntas, hace todas las medidas del artículo y guarda cada probabilidad, así que cualquiera puede repetirlas o comprobarlas.
Tres formas de leer la respuesta
Los tres programas que comparó Hugging Face no se diferenciaban en el examen, sino en lo que hacían
con las probabilidades del modelo después de Answer:. Con el mismo modelo, el mismo prompt y la
misma pregunta, las tres lecturas pueden dar tres respuestas distintas, y la figura lo enseña con la
pregunta de geografía del ejemplo y SmolLM2.
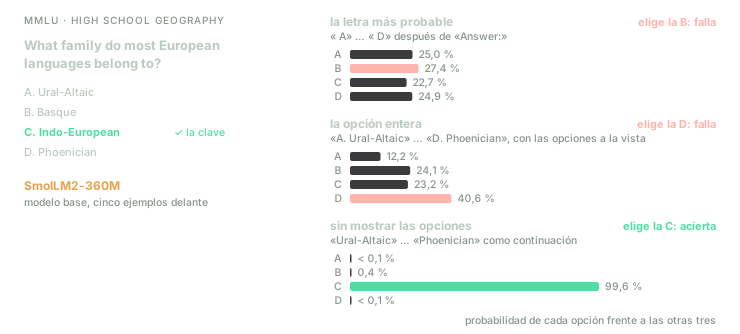
Una pregunta, un modelo y tres formas de leer su respuesta. Con las opciones a la vista, SmolLM2 reparte la probabilidad casi a partes iguales entre las cuatro letras; sin ellas, da a «Indo-European» el 99,6 %.
La letra más probable
El código original de MMLU mira sólo cuatro de esas probabilidades, las de las letras A, B, C y D, y se queda con la mayor. El modelo no llega a escribir nada: basta un paso del modelo por pregunta, y siempre sale una de las cuatro opciones.
Los dos modelos ponen casi toda la probabilidad del token siguiente en esas cuatro letras, de media
el 99,4 % SmolLM2 y el 99,8 % Qwen2.5: los cinco ejemplos les han enseñado que después de Answer:
va una letra. Pero que diga una letra no quiere decir que sepa cuál. En la pregunta de geografía,
SmolLM2 da a las cuatro entre un 23 % y un 27 %, y en el examen entero acierta un 24,7 %, lo mismo
que contestando al azar: elige la A en 245 de las 570 preguntas y la B en 216, sea cual sea la
pregunta. Qwen2.5, en cambio, acierta un 52,3 %, su mejor nota de todas las lecturas de este
artículo, y en la pregunta de geografía da a la C el 92 %.
Incluso esta lectura tiene una trampa. Un token incluye el espacio que lo precede, y en Answer: A
el token que sigue a los dos puntos no es «A», sino « A», con el espacio delante (cómo se parte un
texto en tokens lo cuenta la lección sobre BPE, byte pair
encoding, el algoritmo con que se construyen los vocabularios de los modelos). Un programa que
compare las probabilidades de «A», «B», «C» y «D» sin espacio está mirando tokens que el texto nunca
pone ahí, y la nota cambia. Qwen2.5 baja del 52,3 % que saca leyendo bien la letra, con el espacio, a
un 48,9 %: 19 preguntas menos de 570, una diferencia pequeña pero mayor que su margen. SmolLM2 pasa
de su 24,7 % a un 27,2 %, que es ruido. Que el error cueste poco es justo lo que lo hace peligroso: la
cifra sale razonable, y nadie la revisa.
La opción entera más probable
El Harness de 2023 hacía otra cosa: calculaba la probabilidad de cada opción completa como continuación del texto, « C. Indo-European» entera, y se quedaba con la más probable. La probabilidad de una secuencia es el producto de las probabilidades de sus tokens, cada una menor que 1, así que una opción larga parte con desventaja sólo por ser larga. Por eso se suele dividir por el número de tokens, o de caracteres. Aun así, esa probabilidad mide también lo corriente que es la frase, y no sólo si es la respuesta correcta.
Hay una variante que no enseña las opciones. El prompt es sólo la pregunta y Answer:, y cada
opción se puntúa como posible continuación, como en un ejercicio de rellenar huecos. Se llama
formulación cloze, por ese tipo de ejercicio, y es la forma clásica de evaluar a un modelo que no
sabe responder con una letra.
Con las opciones a la vista, SmolLM2 sigue en el azar: un 24,0 %, o un 24,9 % dividiendo por tokens. Sin ellas, y dividiendo por caracteres, sube al 38,2 %, y en la pregunta del ejemplo da a «Indo-European» el 99,6 % de la probabilidad de las cuatro. El modelo sabe más de lo que deja ver la lectura de la letra; lo que no sabe es asociar cada respuesta con su letra. Qwen2.5 hace el camino contrario: del 52,3 % leyendo la letra baja a un 47,2 % con la opción entera, a un 39,6 % dividiendo por tokens y a un 35,4 % sin opciones.
Lo que el modelo escribe
HELM dejaba que el modelo generara texto y lo comparaba con la letra correcta. Si lo más probable no es una letra, sino un salto de línea o un «The», la respuesta cuenta como fallo aunque la letra correcta tuviera más probabilidad que las otras tres. Con modelos base y cinco ejemplos delante casi no pasa: con los dos modelos, el token más probable fue una letra en las 570 preguntas, y esta lectura coincide exactamente con la de la letra más probable.
Es, sin embargo, la lectura más usada hoy, por dos motivos. Muchos modelos sólo se pueden usar a través de una API (application programming interface, la interfaz con que un programa usa un servicio de otro) que no devuelve las probabilidades, o sólo las de unos pocos tokens. Y los modelos de conversación y los de razonamiento no contestan con una letra: explican, razonan y al final dan una respuesta que hay que encontrar en el texto, normalmente pidiéndoles un formato fijo, como «Answer: B», y buscándolo con un patrón. Una respuesta con otro formato cuenta como fallo, así que esta lectura mide además si el modelo respeta el formato.
Qué lectura es la justa
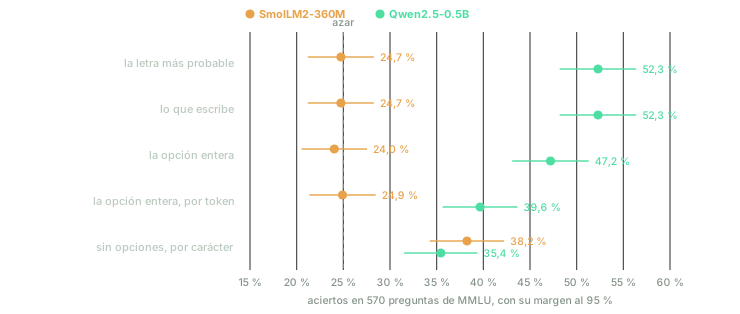
Los dos modelos, leídos de cinco formas sobre las mismas 570 preguntas. Leyendo la letra, Qwen2.5 saca 27,5 puntos a SmolLM2; sin mostrar las opciones, no se distinguen.
Los dos modelos responden de formas opuestas. Qwen2.5 acierta más cuanto más se parece la lectura a un examen tipo test: un 52,3 % leyendo la letra y un 35,4 % sin opciones, casi 17 puntos menos. SmolLM2 sólo supera el azar cuando no ve las opciones. Leyendo la letra, Qwen2.5 le saca 27,5 puntos sobre las mismas preguntas; sin opciones, SmolLM2 queda incluso por delante, por 2,8, una diferencia que cabe en su margen de ±3,4. Según cómo se lea la respuesta, Qwen2.5 es muchísimo mejor que SmolLM2, o no se distinguen. Es lo que les pasaba a LLaMA 65B y Falcon 40B en la tabla de Hugging Face, en pequeño y con dos modelos que cualquiera puede ejecutar.
Joshua Robinson y sus coautores le pusieron nombre en 2022: leer la letra sólo funciona si el modelo sabe asociar cada opción con su símbolo, lo que llaman multiple choice symbol binding, y esa capacidad varía mucho de un modelo a otro. Los que la tienen rinden bastante más leyendo la letra, porque ven las cuatro opciones a la vez y pueden compararlas. Los que no la tienen sólo dan señal sin opciones. OLMES (Open Language Model Evaluation Standard), el estándar de evaluación que propuso en 2024 el Allen Institute for AI (AI2), un instituto de investigación sin ánimo de lucro de Seattle, resuelve el dilema evaluando cada modelo de las dos formas y quedándose con la mejor. Las diferencias no son pequeñas. Llama 3 70B, el modelo de Meta de 2024, acierta el 93,7 % de ARC-Challenge (AI2 Reasoning Challenge), un banco de pruebas de preguntas de ciencias escolares del mismo instituto, leyendo la letra, y el 69,0 % sin opciones. Y OLMo 7B (Open Language Model), un modelo abierto del instituto, respondía al azar con letras durante la primera parte de su entrenamiento: la capacidad apareció hacia los 400 000 millones de tokens.
Eso explica la tabla de Hugging Face del principio. El Harness de 2023 leía la opción entera, que da algo de señal a los modelos que no saben asociar letras, y por eso los más débiles subían del 25 % a más del 33 %. A LLaMA 65B, que sí sabe, lo juzgaba por lo probable que era cada frase completa, y le quitaba quince puntos. Ninguna lectura es la correcta en abstracto: cada una mide una capacidad algo distinta, y la condición mínima es que sea la misma para todos los modelos que se comparan.
Cómo se pregunta
Leer la respuesta es la mitad del instrumento. La otra mitad es el texto que se pone delante del modelo, que mueve la nota aunque no cambie nada de lo que se pregunta.
El ejemplo más sencillo es el orden de las opciones. Las mismas cuatro opciones se pueden presentar en cualquier orden, y la respuesta correcta debería ser la misma. Para comprobarlo he repetido las 570 preguntas cuatro veces, rotando las opciones para que la respuesta correcta quede siempre en la A, luego siempre en la B, y así hasta la D, y leyendo la letra más probable.
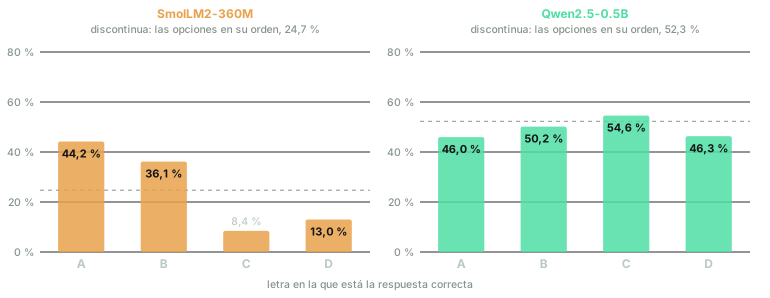
Las mismas 570 preguntas, con la respuesta correcta movida a cada una de las cuatro letras. SmolLM2 acierta cuando la clave cae en la letra que ya iba a decir; Qwen2.5 se mueve 8,6 puntos.
SmolLM2 acierta un 44,2 % cuando la respuesta correcta está en la A y un 8,4 % cuando está en la C. No es que sepa más con la A: dice A o B en cuatro de cada cinco preguntas, y acierta cuando la clave cae donde ya iba a responder. Qwen2.5, que sí asocia las letras con las opciones, depende mucho menos del orden: acierta entre un 46,0 % y un 54,6 % según dónde esté la clave, con una preferencia leve por la C, que elige en el 29,6 % de las respuestas. Aun así, 8,6 puntos entre la mejor letra y la peor es más que su margen. Chujie Zheng y sus coautores midieron este sesgo en 20 modelos en 2023. Con todas las respuestas correctas en la A, LLaMA 30B acertaba el 68,2 % de MMLU; con todas en la D, el 41,2 %: 27 puntos de diferencia con las mismas preguntas. La causa principal, según su análisis, es que el modelo da de partida más probabilidad a ciertas letras, digan lo que digan las opciones. La corrección es barata: barajar las opciones varias veces y promediar, o estimar esa preferencia y descontarla.
El formato pesa todavía más. Melanie Sclar y sus coautores (2023) cambiaron detalles que no tocan el significado del prompt, como el separador entre la pregunta y la respuesta, los espacios o las mayúsculas, y la exactitud de LLaMA-2-13B, un modelo de Meta, en una misma tarea llegó a variar 76 puntos de un formato a otro. Otro estudio, de Moran Mizrahi y sus coautores (2024), evaluó 20 modelos en 39 tareas con cientos de redacciones distintas de las mismas instrucciones, y el orden de los modelos cambiaba con la redacción: en una tarea, el mismo modelo quedaba primero con una y noveno con otra. Por eso un estándar como OLMES fija el prompt exacto y los ejemplos de cada tarea, y por eso conviene dar la nota con varios prompts, o como mínimo con el mismo para todos los modelos.
Si el modelo ya ha visto el examen
Los bancos de pruebas son públicos y están en la web, y los modelos se entrenan con la web. Las preguntas de MMLU están en el repositorio del artículo, en copias, traducciones y foros donde alguien pregunta por una de ellas. Si las preguntas de prueba, o sus respuestas, entraron en los datos de entrenamiento, una parte de la nota mide memoria, y eso es la contaminación.
Quien tiene los datos de entrenamiento puede buscarla. Los autores de GPT-3, el modelo de lenguaje que OpenAI publicó en 2020, buscaron secuencias de trece palabras seguidas que aparecieran a la vez en los bancos de pruebas y en los datos con que iban a entrenar, y quitaron las coincidencias. Un fallo de programación hizo que algunas se quedaran, y contaron en su artículo que reentrenar el modelo era demasiado caro, así que midieron cada banco de pruebas también sin las preguntas sospechosas. Buscar secuencias exactas, además, tiene un límite: un estudio de 2023 sobre preguntas reformuladas entrenó un modelo de 13 000 millones de parámetros con versiones reescritas o traducidas de las preguntas de MMLU y de otros exámenes, y el modelo igualó a GPT-4 sin que la búsqueda de coincidencias detectara nada.
Quien no tiene los datos, que es casi todo el mundo, sólo puede preguntarle al modelo. Hay dos ideas. La primera mira el orden. Las preguntas de un banco de pruebas se publican en un orden concreto, pero cualquier otro orden sería igual de válido; un modelo que no las ha visto no tiene motivo para preferir uno. Un modelo que las memorizó, sí: da más probabilidad al orden publicado que a los órdenes barajados. La prueba de Oren y sus coautores (2023) compara las dos probabilidades y funciona con modelos desde 1 400 millones de parámetros y unos mil ejemplos. Aplicada a cinco modelos públicos, encontró poca evidencia de una contaminación generalizada. La segunda mira las palabras improbables: un texto que el modelo no ha visto suele tener algunas palabras a las que da muy poca probabilidad, y uno visto en el entrenamiento casi no las tiene. Min-K% Prob (2023) puntúa un texto por la probabilidad media de su porcentaje de tokens más improbables. Ninguna de las dos es concluyente para una pregunta suelta; sobre cientos, dan una señal.
La comprobación más directa es escribir preguntas nuevas. GSM8K (Grade School Math 8K) es un banco de pruebas muy usado de unos 8 500 problemas de matemáticas de primaria. En 2024, la empresa de datos Scale AI escribió GSM1k, 1 205 problemas nuevos con su estilo y su dificultad, y no los publicó. Algunas familias de modelos perdían hasta 8 puntos al pasar de uno a otro.
Para evitarla, hay tres costumbres. La primera es marcar los ficheros: BIG-bench (Beyond the Imitation Game), un banco de pruebas colectivo de 2022 con más de doscientas tareas, lleva en cada fichero una cadena canaria, un identificador único que quien prepara datos de entrenamiento puede buscar para quitarlos. La segunda es no publicar las preguntas de prueba y corregir en un servidor. La tercera es usar preguntas posteriores al entrenamiento de los modelos: LiveBench (2024) se renueva cada mes con problemas de concursos de matemáticas recientes, artículos y noticias, y todas sus respuestas se comprueban sin jueces. Una evaluación propia, con preguntas que nunca se han publicado, está a salvo por construcción, hasta el día en que alguien la sube a un repositorio público.
Cuántas preguntas hacen falta
Una nota sobre preguntas es una estimación: la proporción de aciertos que tendría el modelo sobre todas las preguntas como ésas, medida con una muestra. Si acierta una proporción , el margen de error al 95 % es aproximadamente
Con las 570 preguntas de las medidas, cada nota tiene un margen de unos ±4 puntos: ±3,5 para un 25 % y ±4,0 para un 40 %. Los 13,5 puntos que gana SmolLM2 cuando no ve las opciones son una diferencia real; los 0,7 que separan la lectura de la letra de la de la opción entera, no. Comparando los dos modelos sobre las mismas preguntas, los 27,5 puntos que Qwen2.5 saca a SmolLM2 leyendo la letra tienen un margen de ±5,5, y los 2,8 que SmolLM2 le saca sin opciones, de ±3,4.
Comparar sobre las mismas preguntas
Lo que suele interesar no es una nota, sino la diferencia entre dos, y ahí el margen depende de cómo se haga la comparación. Un ejemplo pequeño lo enseña. Una empresa de software de facturación, llamémosla Albarán, tiene un asistente que responde a su equipo de soporte, y prueba dos versiones nuevas sobre 200 preguntas reales cerradas: cada una se responde con un sí o un no y una fecha, y un programa las compara con la clave. La versión 1 acierta el 70 %, 140 preguntas, y la versión 2 el 74 %, 148.
Si las dos versiones hubieran respondido a 200 preguntas distintas cada una, el margen de la diferencia sería de unos ±8,8 puntos, y 4 puntos de ventaja no dirían nada. Pero han respondido a las mismas, y entonces lo que cuenta es en cuántas preguntas no coinciden. Para cada pregunta se apunta si sólo acierta la versión 2, si sólo acierta la 1 y si las dos aciertan o las dos fallan. La ventaja es la media de esos números, y su margen se calcula con la misma idea de antes, sobre esos 200 números. Las preguntas en las que las dos coinciden aportan ceros, y no añaden ruido: la dificultad de cada pregunta afecta a las dos versiones por igual y se descuenta.
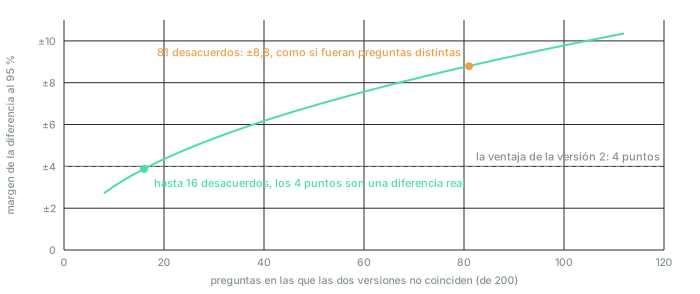
El margen de una ventaja de 4 puntos sobre las mismas 200 preguntas, según en cuántas no coinciden las dos versiones. Si la versión 2 sólo cambia unas pocas respuestas, la ventaja es real; si cambia muchas, es ruido.
Si la versión 2 corrige 10 respuestas y estropea 2, las dos versiones no coinciden en 12 preguntas, y el margen es de ±3,4 puntos: la ventaja es real. Si corrige 14 y estropea 6, la ventaja sigue siendo de 8 preguntas, pero no coinciden en 20, y el margen sube a ±4,4: ya no se puede decir. Con hasta 16 desacuerdos, los 4 puntos superan su margen. Si las dos versiones fallaran con independencia, sin tener en común qué preguntas les cuestan, discreparían en unas 81 y el margen volvería a ser el de ±8,8. Evan Miller lo desarrolla, junto con el resto de este apartado, en Adding Error Bars to Evals (2024), y recomienda comparar siempre sobre las mismas preguntas cuando se pueda.
Preguntas que van en grupo
La fórmula supone que cada pregunta es independiente de las demás, y no siempre lo es. En un banco de pruebas de comprensión lectora, varias preguntas comparten el mismo texto, y un modelo que entiende el texto tiende a acertarlas todas, y uno que no lo entiende, a fallarlas todas. En la práctica hay menos información de la que parece, y el margen tiene que calcularse por grupos. Miller mide que el margen agrupado puede ser más de tres veces mayor que el ingenuo: 3,05 veces en DROP (Discrete Reasoning Over Paragraphs), un banco de pruebas de preguntas sobre párrafos de Wikipedia.
Respuestas que cambian de una ejecución a otra
Si el modelo genera su respuesta sorteando entre los tokens más probables, la misma pregunta puede recibir una respuesta distinta en dos ejecuciones, y la nota se mueve también por eso. Hay dos remedios: responder cada pregunta varias veces y promediar, o, cuando se tienen, usar las probabilidades en lugar del sorteo, que eliminan esa parte del ruido. Lo que Miller desaconseja es bajar la temperatura del sorteo sólo para que la nota se mueva menos, porque entonces se mide otro modelo, uno que nadie usa así.
Cuántas preguntas
Todo esto se puede dar la vuelta para planificar: decidir qué diferencia se quiere poder ver y calcular cuántas preguntas hacen falta. Con los supuestos de un ejemplo típico de Miller, ver una diferencia de 3 puntos entre dos modelos con una probabilidad razonable (del 80 %) exige unas mil preguntas, y de ahí su recomendación de que un banco de pruebas nuevo tenga al menos ésas.
Cuando el examen se queda corto
Una nota tiene un suelo y un techo, y los dos están más lejos del 0 y del 100 de lo que parece.
El suelo es el azar. Con cuatro opciones, contestar al azar da un 25 %, y contestar siempre la D da un 26,9 % en MMLU, porque la D es la clave del 26,9 % de sus preguntas. Un 30 % no es «un 30 % de conocimiento»: es apenas algo más que nada. Por eso la versión de 2024 de la clasificación de Hugging Face, al cambiar de exámenes, reescala las notas para que el azar valga 0 y el acierto total, 100: en un examen de cuatro opciones, un 60 % bruto se convierte en un 46,7.
El techo son los errores del propio examen. Una revisión de 2024, Are We Done with MMLU?, estimó que el 6,5 % de las preguntas de MMLU tienen algún error (una clave equivocada, una pregunta ambigua, más de una opción correcta), y que en virología son el 57 %. Ni siquiera los ejemplos resueltos se libran: el primero del prompt de geografía de más arriba dice crude birth date (fecha de nacimiento) donde debería decir crude birth rate (tasa de natalidad). Un modelo perfecto no llegaría al 100 %, y cerca del techo una parte de lo que separa a dos modelos es cuál coincide más con los errores de la clave. En junio de 2024, Anthropic y OpenAI publicaron para sus modelos punteros, Claude 3.5 Sonnet y GPT-4o, el mismo 88,7 %.
Cuando un banco de pruebas se satura, se sustituye por otro más difícil. MMLU-Pro (2024) sube de cuatro a diez opciones, con lo que el azar baja al 10 %, y cambia preguntas de memoria por preguntas que exigen razonar: los modelos pierden entre 16 y 33 puntos al pasar de MMLU a MMLU-Pro. De paso, la nota depende menos del prompt: en 24 estilos de prompt distintos, la variación baja de 4 o 5 puntos a 2. La clasificación de Hugging Face hizo ese cambio en 2024, cuando sustituyó sus seis exámenes, MMLU entre ellos, por seis más difíciles, MMLU-Pro entre ellos, y explicó por qué: los mejores modelos rozaban el nivel humano, algunos se habían entrenado probablemente con las preguntas, y algunos exámenes tenían errores.
Cómo leer el número de una ficha
En diciembre de 2023, Google presentó Gemini Ultra, su modelo más capaz, con un 90,0 % en MMLU, por encima del 89,8 % que se estima para un experto humano. La tabla del informe técnico lo ponía al lado del 86,4 % de GPT-4. Las dos cifras salían de procedimientos distintos. El 86,4 % de GPT-4 era el que había publicado OpenAI, con cinco ejemplos y una sola respuesta. El 90,0 % de Gemini usaba lo que el informe llama CoT@32: el modelo razona antes de responder (chain of thought, cadena de pensamiento), lo hace 32 veces y, si bastantes respuestas coinciden, se queda con la mayoritaria; si no, responde directamente, sin razonar. En el apéndice, el mismo informe compara los dos modelos con el mismo procedimiento, midiendo GPT-4 a través de la API de OpenAI. Con una sola respuesta, eligiendo en cada paso el token más probable, Gemini Ultra sacaba un 84,0 % y GPT-4 un 84,2 %. Con el procedimiento de las 32 respuestas para los dos, un 90,0 % y un 87,3 %. Mismo examen, mismos dos modelos, y quién gana depende de cómo se pregunte.
No hay nada falso en la tabla, y el procedimiento está escrito en ella. Pero la cifra que viaja es la del titular, y lo que hay que hacer con cualquier nota de un banco de pruebas es preguntar cómo se obtuvo. Las preguntas son siempre las mismas.
- ¿Con qué programa y qué versión? El LM Evaluation Harness de 2023 y el de hoy no dan lo mismo.
- ¿Cómo se leyó la respuesta? La letra más probable, la opción entera o el texto generado.
- ¿Con cuántos ejemplos, con qué prompt y con o sin razonamiento?
- ¿Una respuesta o varias? Y si son varias, cómo se combinan.
- ¿Sobre qué preguntas? El examen entero o una parte, y cómo se promedió.
- ¿Con qué margen? Y si se compara con otro modelo, si fue sobre las mismas preguntas.
- ¿Pudo el modelo ver el examen? Si nadie lo comprobó, no se sabe.
Dos cifras sólo se comparan si salen del mismo programa con la misma configuración. Las de la ficha de un modelo las midió quien lo hizo, con su programa y su configuración, y las de otra ficha, otro equipo con los suyos.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: la nota de un banco de pruebas es una medida, y una medida depende del instrumento. El examen fija las preguntas y la clave, pero no cómo se pregunta, cómo se lee la respuesta, qué preguntas cuentan ni cuántas son, y cualquiera de esas cuatro decisiones mueve la nota más que la distancia entre dos modelos.
| antes de fiarte de la nota, pregunta… | por qué |
|---|---|
| cómo se leyó la respuesta | LLaMA 65B saca un 63,6 % o un 48,8 % en MMLU; Qwen2.5 le saca 27,5 puntos a SmolLM2 leyendo la letra, y ninguno sin opciones |
| con qué prompt, cuántos ejemplos y en qué orden | mover la respuesta correcta de la A a la D cambia la nota de LLaMA 30B en 27 puntos; un cambio de formato, hasta 76 |
| si el modelo pudo ver las preguntas | algunas familias pierden hasta 8 puntos con problemas nuevos (GSM1k) |
| sobre cuántas preguntas, y si la comparación fue sobre las mismas | con 200 preguntas, 4 puntos pueden ser ruido o una diferencia real |
| dónde está el suelo y dónde el techo | con cuatro opciones, el azar da un 25 %; MMLU tiene un 6,5 % de preguntas con errores |
Y si te llevas algo más, que sea práctico.
Fija el instrumento antes de comparar. El mismo programa, la misma versión, el mismo prompt, los mismos ejemplos y la misma forma de leer la respuesta para todos los modelos, y escríbelo junto a la nota.
Lee la respuesta de una forma que el modelo pueda dar. Un modelo que no sabe asociar letras saca lo mismo que el azar si se lee la letra, y uno que sí sabe pierde puntos si se lee la frase entera. Si comparas modelos muy distintos, mide las dos formas, como hace OLMES, y di cuál usas.
Baraja las opciones. Si la nota cambia al mover la respuesta correcta de sitio, estás midiendo la preferencia del modelo por una letra.
Compara sobre las mismas preguntas y pon margen a la diferencia. Lo que importa es en cuántas preguntas no coinciden los dos modelos.
Desconfía de un examen que todos aprueban. Cerca del techo, la nota mide los errores de la clave; cerca del suelo, poco más que el azar.