 Por Gustavo Torres
Este programa en C (primero.c) guarda cuatro números en un vector que crece solo, se queda con un puntero a su primer elemento, añade un quinto número e imprime el primero:
#include <stdio.h>
#include <stdlib.h>

typedef struct { int *datos; size_t len, cap; } Vector;

/* Añade x al final; si no cabe, pide un bloque el doble de grande. */
void push(Vector *v, int x) {
    if (v->len == v->cap) {
        v->cap = v->cap ? 2 * v->cap : 4;
        v->datos = realloc(v->datos, v->cap * sizeof *v->datos);
    }
    v->datos[v->len++] = x;
}

int main(void) {
    Vector v = {0};
    for (int i = 1; i <= 4; i++) push(&v, i);

    int *primero = &v.datos[0];
    push(&v, 5);
    printf("primero = %d\n", *primero);
}
Compila sin un solo aviso, incluso con -Wall -Wextra, que activan buena parte de los avisos del
compilador. Imprime primero = 1, que es lo correcto, con y sin optimizaciones. Pasaría cualquier
prueba. Y está mal. Compilado con
AddressSanitizer, una opción de gcc y de clang
que vigila cada acceso a memoria mientras el programa se ejecuta, dice esto (recortado):
ERROR: AddressSanitizer: heap-use-after-free on address 0x75f2c59e0010
READ of size 4 at 0x75f2c59e0010 thread T0
    #0 in main primero.c:21
La línea 21 lee, a través de primero, un bloque que realloc ya había liberado. Que imprima
un 1 es suerte, y la suerte depende de cosas que no están en estas veinte líneas. Las mismas
operaciones en Rust son cuatro líneas, y no compilan:
let mut v = vec![1, 2, 3, 4];
let primero = &v[0];
v.push(5);
println!("primero = {primero}");
error[E0502]: cannot borrow `v` as mutable because it is also borrowed as immutableÉsa es, en pequeño, la diferencia entre los dos lenguajes, y la razón de que buena parte de la industria esté escribiendo en Rust lo que hace diez años habría escrito en C. C deja en manos del programador tres hechos que el compilador no comprueba: cuánto mide un bloque de memoria, cuánto tiempo vive y quién lo toca a la vez. Si alguno falla, el programa no se detiene: sigue, con datos equivocados o con datos ajenos. Rust convierte esos tres hechos en reglas que el compilador comprueba antes de generar el programa. Lo paga con una curva de aprendizaje, compilaciones más lentas y fricción con el C que ya existe, y por eso la sustitución es lenta, parcial y, en algunos sitios, no va a llegar nunca.
Un puntero en C es una variable que guarda una dirección de memoria: primero no guarda un 1,
guarda dónde está el 1. Un programa usa dos zonas de memoria. La pila (stack) guarda las
variables locales de cada función y se libera sola al volver de ella. El heap guarda los
bloques que el programa pide mientras se ejecuta, y que en C tiene que liberar él mismo.
Un lenguaje es seguro con la memoria si un programa escrito en él no puede
leer ni escribir fuera de los bloques que le pertenecen, ni usar uno después de liberarlo.
El ejemplo usa realloc, que cambia el tamaño de un bloque de memoria ya reservado (normalmente, para
agrandarlo) y conserva los datos que había en él. Si justo detrás del bloque hay suficiente memoria
libre, realloc lo estira en el mismo sitio y devuelve la misma dirección. Si detrás hay otro bloque
ocupado, no puede estirarlo: reserva uno nuevo en otra parte, copia en él los datos, libera el viejo
y devuelve una dirección distinta. Ése es el peligro del programa: primero sigue guardando la
dirección vieja, y nada en C le avisa de que ha dejado de valer.
Todos los resultados del artículo están medidos. Cada ejemplo enlaza a su programa, y un script los compila y los ejecuta todos, así que cualquiera puede repetirlos. El compilador de C es gcc 15.2, con la norma C23, y el de Rust, rustc 1.99.
Por qué C está en todas partes
C nació en 1972 en los Bell Labs, de la mano de Dennis Ritchie, para escribir Unix, y al año siguiente Unix ya estaba reescrito en él. Era un lenguaje pequeño, pensado para estar a un paso de la máquina: sus tipos son los del procesador, un array es una dirección de memoria y una cuenta, y lo que el programa no pide explícitamente no ocurre. Por eso se llamó a C un «ensamblador portátil». Un compilador de C era fácil de escribir, y cada procesador nuevo tuvo enseguida el suyo. Con él se podía llevar Unix, y todo lo escrito encima, a cualquier máquina.
Cincuenta años después, C sigue debajo de casi todo. El núcleo de Linux está escrito en C, igual que buena parte del de Windows y el de macOS. También la biblioteca estándar de C de cada sistema, por la que pasa cualquier programa que abre un fichero o una conexión. Y SQLite, Postgres, Redis, el intérprete de Python, OpenSSL, curl, y el firmware de casi todos los microcontroladores que hay dentro de un coche, una lavadora o un marcapasos.
Hay una segunda razón, menos visible, por la que C está en todas partes: su ABI (application binary interface, interfaz binaria de aplicación), las convenciones de cómo una función compilada recibe sus argumentos y devuelve su resultado. Los sistemas operativos publican sus servicios como funciones de C, y casi cualquier lenguaje que quiera hablar con otro lo hace a través de ellas: Python llama a bibliotecas de C, Java también, y un programa en Rust que quiere abrir un fichero en Linux acaba en una función de C. C no es sólo un lenguaje en el que se escribe software, es el idioma común en el que el software se habla.
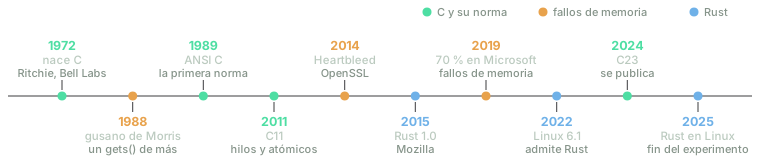
No a escala. Los fallos de memoria acompañan a C desde el principio: el gusano de Morris, de 1988, entraba por una lectura sin límite en un servidor de Unix.
Por eso sustituirlo no es como cambiar de lenguaje en una aplicación web. Hay miles de millones de líneas de C en producción, mucho de ese código lleva décadas funcionando, y todo lo demás se comunica con él.
Lo que C deja en manos del programador
C se diseñó con una filosofía que su propio comité de normalización resumió durante años en una frase: trust the programmer, confía en el programador. El lenguaje no comprueba lo que el programador sabe, y esa confianza recae sobre tres hechos.
Cuánto mide un bloque de memoria. En C, un array que se pasa a una función se convierte en un puntero a su primer elemento, y la longitud se pierde por el camino. La función recibe una dirección y tiene que creerse lo que le digan sobre cuánto hay detrás. Nada impide leer el elemento cien de un array de cuatro: el programa calcula la dirección y lee lo que haya allí.
Cuánto tiempo vive. Un bloque pedido con malloc vive hasta que alguien llama a free. El
compilador no sabe quién es el responsable de liberarlo, ni si quedan punteros que apuntan a él
cuando se libera. Si se libera dos veces, o se usa después, el programa no se entera.
Quién lo modifica a la vez. Dos hilos de ejecución pueden escribir la misma variable al mismo tiempo. C11 añadió hilos y operaciones atómicas a la norma, pero el compilador no comprueba qué datos comparte cada hilo, ni si los protege.
Detrás de los tres hay un cuarto problema, más sutil: el comportamiento indefinido (undefined behavior). La norma de C enumera las situaciones en las que no dice qué debe pasar (el último borrador público de C23 cuenta 221), entre ellas leer fuera de un array, usar un puntero a memoria ya liberada, que dos hilos se pisen una variable o que una suma de enteros con signo se pase del máximo. No significa «el resultado es impredecible», sino algo más fuerte: el compilador puede suponer que eso nunca ocurre, y optimizar en consecuencia. Si ocurre, el programa ha dejado de tener significado, y lo que haga, incluido funcionar, es casualidad.
El propio comité de C reconoció en 2007, al preparar C11, que confiar en el programador era, para quien se ocupa de la seguridad, un objetivo anticuado, y lo dejó escrito en la carta que guía cada revisión de la norma. Los números le dan la razón. Microsoft contó en 2019 que alrededor del 70 % de las vulnerabilidades a las que asigna un CVE cada año (el identificador público con el que se registra un fallo de seguridad) son fallos de memoria, y que esa proporción apenas se había movido en doce años. Chromium, el proyecto del que sale Chrome, da la misma cifra para sus fallos de seguridad graves, y la mitad de ellos son usos de memoria ya liberada. Android estaba en el 76 % en 2019. Las tres cifras son de código en C y en C++, que comparte con C el modelo de memoria y, con él, los mismos fallos.
Cinco errores, en C y en Rust
Cada uno de los cinco ejemplos que siguen sigue el mismo orden: el programa en C, lo que pasa al ejecutarlo, el mismo programa en Rust y lo que dice el compilador de Rust o el programa al ejecutarse. Los cinco compilan con gcc sin ningún aviso.
Leer más allá del final
En abril de 2014 se supo que Heartbleed, un fallo en OpenSSL, la biblioteca con la que se cifraban buena parte de las conexiones de Internet, llevaba dos años publicado. El protocolo tenía un mensaje de latido (heartbeat): el cliente envía unos bytes y dice cuántos ha enviado, y el servidor se los devuelve para demostrar que sigue vivo. El servidor se creía la longitud que le decían. Si el cliente enviaba cuatro bytes y decía que eran 64 KB, el servidor devolvía los cuatro bytes y casi 64 KB más de su memoria, con lo que hubiera allí: contraseñas, cookies de sesión, claves privadas.
Este programa (latido.c) reproduce el fallo a escala:
char *clave_del_servidor;   /* un secreto que el servidor guarda en memoria */

/* Responde a un latido: devuelve los `longitud` bytes que el cliente dice haber enviado. */
char *responder(const char *mensaje, size_t longitud) {
    char *respuesta = malloc(longitud);
    memcpy(respuesta, mensaje, longitud);
    return respuesta;
}

int main(void) {
    char *mensaje = malloc(4);
    memcpy(mensaje, "HOLA", 4);                 /* el cliente envía 4 bytes */

    clave_del_servidor = malloc(32);
    strcpy(clave_del_servidor, "clave-privada-del-servidor");

    char *r = responder(mensaje, 64);           /* pero dice que ha enviado 64 */
    for (int i = 0; i < 64; i++)
        putchar(r[i] >= 32 && r[i] < 127 ? r[i] : '.');
    putchar('\n');
}HOLA....................1.......clave-privada-del-servidor......La respuesta lleva el mensaje, unos bytes que malloc usa para llevar la cuenta de sus bloques
(los puntos y el 1) y, después, la clave, que estaba en el bloque siguiente. Lo mismo a -O0, a
-O2 y a -O3. AddressSanitizer lo ve: heap-buffer-overflow, una lectura de 64 bytes que
empieza justo al final de un bloque de 4. Pero sólo si el programa se compila con él, y en
producción casi nunca se hace, porque lo hace bastante más lento.
En Rust, una referencia a un trozo de array no es sólo una dirección: es la dirección y la longitud, juntas, y el lenguaje no deja separarlas. A ese par se le llama slice. La misma función queda así:
fn responder(mensaje: &[u8], longitud: usize) -> Vec<u8> {
    mensaje[..longitud].to_vec()
}
Y al ejecutarla con la misma mentira:
thread 'main' (19168) panicked at latido.rs:3:12:
range end index 64 out of range for slice of length 4
El programa se detiene en vez de enviar la clave. Un panic de Rust es una parada controlada: el
hilo deja de ejecutarse y libera lo que tenía, sin tocar memoria ajena. Para un servidor, que un
mensaje mal formado lo tumbe tampoco es bueno, y la forma idiomática de escribirlo pide el trozo
con get, que devuelve «algo o nada» y obliga a decidir qué hacer en cada caso:
match mensaje.get(..longitud) {
    Some(trozo) => trozo.to_vec(),     // la longitud cuadra
    None => return None,               // latido mal formado: se descarta
}
Lo que cuesta. Comprobar el índice en cada acceso no es gratis, pero casi siempre lo parece. El
ejemplo de medida suma 16 millones de números de dos
formas. Seguidos, del primero al último, Rust tarda lo mismo que C (10,2 ms frente a 10,0): el
compilador ve que el índice nunca pasa de la longitud y quita la comprobación. Salteados, con
índices que vienen de otro array y que el compilador no puede predecir, la comprobación se queda.
Con una tabla pequeña, que cabe entera en la memoria caché del procesador, sumar con comprobación
cuesta 16,0 ms y sin ella, 12,8: un 25 % más. Es el peor caso posible, un bucle que no hace otra
cosa que leer, y aun así la cifra es frágil: una versión anterior del mismo programa, casi idéntica,
daba un 55 %. Con una tabla de 16 millones de números, que no cabe en la caché, las tres versiones
tardan lo mismo, alrededor de medio segundo, porque esperar a la memoria cuesta mucho más que
comparar dos números. Cuando la comprobación importa de verdad, Rust deja quitarla con
get_unchecked, pero sólo dentro de un bloque marcado unsafe, del que se habla más abajo.
Usar memoria que ya se ha liberado
Volvamos al programa del principio. Imprime un 1 porque, en ese programa, detrás del bloque del
vector no hay nada: realloc lo estira en el mismo sitio, y primero sigue apuntando al 1 por
casualidad. Basta con que el programa pida memoria para cualquier otra cosa entre medias para que
realloc tenga que mudar el bloque
(primero_movido.c):
    for (int i = 1; i <= 4; i++) push(&v, i);
    char *nombre = strdup("serie");          /* otra reserva, justo detrás del vector */

    int *primero = &v.datos[0];
    push(&v, 5);
    printf("%s: primero = %d\n", nombre, *primero);
serie: primero = 1430334168
serie: primero = -2021578024Un número distinto en cada ejecución, que es lo que malloc escribió en el bloque al liberarlo. El
fallo estaba en el programa original: para la norma de C, después de realloc el puntero viejo deja
de valer aunque la dirección no haya cambiado. La línea nueva, que no tiene nada que ver con el
vector, sólo lo ha hecho visible.
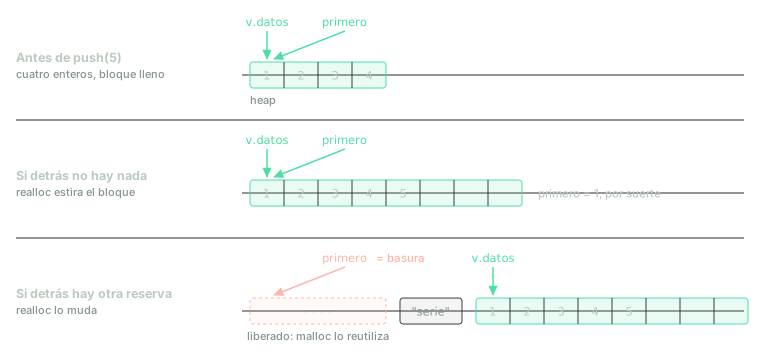
Si nada lo impide, realloc estira el bloque y el puntero viejo sigue valiendo, por suerte. Con otra reserva detrás, lo muda, y el puntero viejo se queda apuntando a memoria liberada.
Leer basura es la versión inofensiva. Si el bloque liberado se reutiliza para otra cosa, escribir a través del puntero viejo modifica esa otra cosa, y un atacante que consiga colocar allí un dato elegido por él puede llegar a controlar el programa. Por eso los usos tras liberar (use-after-free) son la mitad de los fallos de memoria graves de Chromium.
Rust lo evita con dos reglas, que son la idea central del lenguaje y lo que más cuesta aprender de él.
- Cada valor tiene un único dueño. El vector es de la variable
v. Cuandovdeja de existir, el vector se libera solo. No hayfree, y por tanto no hay unfreeolvidado ni uno repetido. Si se asignava otra variable, el vector cambia de dueño (se mueve), y usarvdespués es un error de compilación. - Se puede prestar un valor, pero de una de dos formas, nunca a la vez: a muchos para leerlo
(
&v), o a uno solo para modificarlo (&mut v). Y ningún préstamo puede durar más que el dueño.
primero = &v[0] es un préstamo para leer. v.push(5) necesita un préstamo para modificar, y la
segunda regla no lo permite mientras primero siga en uso. El mensaje completo del compilador
señala las tres líneas implicadas:
error[E0502]: cannot borrow `v` as mutable because it is also borrowed as immutable
 --> primero.rs:6:5
  |
5 |     let primero = &v[0];
  |                    - immutable borrow occurs here
6 |     v.push(5);
  |     ^^^^^^^^^ mutable borrow occurs here
7 |     println!("primero = {primero}");
  |                          ------- immutable borrow later used here
La parte del compilador que aplica estas reglas se llama comprobador de préstamos (borrow
checker). No sabe nada de realloc: no sabe que push puede mudar el bloque. Sólo sabe que
push pide modificar el vector, y que mientras alguien lo está leyendo nadie puede modificarlo.
Esa regla, aplicada sin excepciones, cubre el caso de realloc y todos los parecidos. La solución,
en Rust como en C, es no guardar la dirección: guardar el índice (let primero = 0; y leer
v[primero] después) o copiar el valor (let primero = v[0];).
NULL
En C, una función que busca algo y puede no encontrarlo suele devolver NULL, el puntero que no
apunta a nada. Quien la llama tiene que acordarse de comprobarlo
(buscar.c):
typedef struct { const char *nombre; int nota; } Alumno;

/* Devuelve el alumno con ese nombre, o NULL si no está. */
Alumno *buscar(Alumno *clase, size_t n, const char *nombre) {
    for (size_t i = 0; i < n; i++)
        if (strcmp(clase[i].nombre, nombre) == 0) return &clase[i];
    return NULL;
}

int main(void) {
    Alumno clase[] = {{"Ana", 9}, {"Luis", 6}, {"Sara", 8}};
    printf("Sara: %d\n", buscar(clase, 3, "Sara")->nota);
    printf("Marta: %d\n", buscar(clase, 3, "Marta")->nota);
}
Sara: 8
Violación de segmento (`core' generado)En un programa normal, leer a través de NULL termina así, con el sistema operativo parando el
programa, y es el mejor de los casos. Tony Hoare, que inventó la referencia nula para el lenguaje
ALGOL W en 1965, la llamó en 2009 su «error de mil millones de dólares».
Rust no tiene NULL. Una función que puede no encontrar nada lo dice en su tipo: devuelve
Option<&Alumno>, que es o bien Some(alumno) o bien None.
fn buscar<'a>(clase: &'a [Alumno], nombre: &str) -> Option<&'a Alumno> {
    clase.iter().find(|a| a.nombre == nombre)
}
(El 'a dice que el alumno que devuelve es un préstamo de clase, y que no puede durar más que
ella.) Si se usa el resultado como en C, sin mirar si hay alumno, no compila:
error[E0609]: no field `nota` on type `Option<&Alumno>`El compilador sugiere .unwrap(), que significa «sé que hay alumno, y si no lo hay, detén el
programa». Se puede escribir, pero queda escrito, y quien lea el código ve dónde se ha decidido
correr el riesgo. Lo normal es tratar los dos casos con match. Y no cuesta nada: en Rust, un
Option<&Alumno> ocupa 8 bytes, lo mismo que un &Alumno. El compilador representa None con la
dirección cero, porque una referencia válida nunca la tiene, así que el programa compilado
compara con cero igual que el de C. La diferencia es que en Rust esa comparación no se puede
olvidar.
Dos hilos, un contador
Cuatro hilos suman un millón cada uno a la misma variable (contador.c). El resultado debería ser cuatro millones:
#include <pthread.h>
#include <stdio.h>

long contador = 0;

void *sumar(void *arg) {
    (void)arg;
    for (int i = 0; i < 1000000; i++) contador++;
    return NULL;
}

int main(void) {
    pthread_t hilos[4];
    for (int i = 0; i < 4; i++) pthread_create(&hilos[i], NULL, sumar, NULL);
    for (int i = 0; i < 4; i++) pthread_join(hilos[i], NULL);
    printf("contador = %ld\n", contador);
}
Compilado sin optimizar, cada ejecución da un número distinto, entre 1 y 2,3 millones en
el portátil de prueba. contador++ son tres pasos (leer, sumar, escribir), y cuando dos hilos los intercalan,
uno de los incrementos se pierde. A eso se le llama una carrera de datos (data race).
Compilado con -O2, el resultado es siempre 4 000 000. No porque el fallo haya desaparecido, sino
porque el optimizador ha convertido el bucle entero en una sola instrucción, que suma un millón de
golpe:
sumar:
    addq    $1000000, contador(%rip)
Puede hacerlo porque una carrera de datos es comportamiento indefinido: el compilador tiene derecho
a suponer que ningún otro hilo toca contador mientras el bucle se ejecuta. La ventana en la que
dos hilos se pisan ha pasado de un millón de iteraciones a una instrucción, y el error se ha
escondido. Volverá a aparecer el día que el bucle haga algo más que sumar.
ThreadSanitizer, el equivalente de
AddressSanitizer para hilos, lo detecta: WARNING: ThreadSanitizer: data race.
En Rust, el mismo programa no compila, y por la misma regla de antes. Cada hilo necesita modificar
contador, y sólo puede haber un préstamo para modificar a la vez (el mensaje, recortado):
let mut contador: u64 = 0;
thread::scope(|s| {
    for _ in 0..4 {
        s.spawn(|| {
            for _ in 0..1_000_000 { contador += 1; }
        });
    }
});
error[E0499]: cannot borrow `contador` as mutable more than once at a time
--> contador.rs:8:21
|
8 | s.spawn(|| {
| ^^ `contador` was mutably borrowed here in the previous iteration of the loop
9 | for _ in 0..1_000_000 { contador += 1; }
| -------- borrows occur due to use of `contador` in closureLa regla que evitaba el uso tras liberar evita también la carrera de datos, sin una línea más.
Para compartir algo entre hilos hay que usar un tipo que sepa compartirse: un entero atómico
(AtomicU64, cuyo fetch_add suma de una vez, sin que otro hilo pueda meterse en medio) o un
cerrojo (Mutex). Con el atómico, la versión corregida da 4 000 000 en todas las ejecuciones.
Rust lleva la comprobación un paso más allá: cada tipo declara si se puede enviar a otro hilo y si
se puede compartir entre hilos, y el compilador lo verifica. Un contador de referencias que no es
atómico, por ejemplo, no se puede mandar a otro hilo, y el error aparece al compilar, no al tercer
día en producción.
La comprobación que el compilador borra
El último ejemplo no tiene punteros. La función cabe quiere saber si se puede sumar y a x sin
pasarse del máximo de un int (cabe.c), y lo comprueba de la
forma más natural: si la suma se desborda, el resultado dará la vuelta y será menor que x.
/* ¿Se puede sumar y (positivo) a x sin pasarse del máximo de un int? */
int cabe(int x, int y) {
    return x + y > x;
}
Con x = INT_MAX e y = 1 debería devolver 0. Devuelve 1, con y sin optimizaciones. El
ensamblador que genera gcc sin optimizar ni siquiera mira x:
cabe:
    ...
    cmpl    $0, -8(%rbp)      # compara y con 0
    setg    %al               # devuelve y > 0
Para el compilador, que una suma de enteros con signo se desborde es comportamiento indefinido, así
que puede suponer que no ocurre. Y si no ocurre, x + y > x es lo mismo que y > 0: el álgebra de
toda la vida. La comprobación del desbordamiento ha desaparecido precisamente porque comprobaba un
desbordamiento. Compilado con -fsanitize=undefined, gcc avisa al ejecutar
(signed integer overflow: 2147483647 + 1 cannot be represented in type 'int') y devuelve 0.
No es un caso de libro. En 2009, el núcleo de Linux tenía un fallo de seguridad en un controlador
de red porque una función usaba un puntero y, una línea después, comprobaba si era NULL. Como
usarlo antes ya suponía que no lo era, gcc borró la comprobación. Hoy Linux se compila con opciones
que le prohíben al compilador sacar esas conclusiones: una para los punteros nulos, añadida a raíz
de aquel fallo, y otra para el desbordamiento. Es decir, para un dialecto de C un poco distinto del
de la norma.
En Rust, que una suma se desborde no es comportamiento indefinido. Compilado sin optimizar, el
programa se detiene (attempt to add with overflow); compilado con optimizaciones, la suma da la
vuelta, como en el procesador, y cabe devuelve false, que es lo correcto. Y para preguntar lo
que la función quería preguntar hay una operación que lo dice: x.checked_add(y) devuelve
None si la suma no cabe.
Y las molestias de cada día
Los cinco ejemplos son de seguridad, pero no es sólo eso lo que cansa de C. Hay otras cosas en las que Rust también se aparta de él, y que pesan cuando un proyecto crece:
| En C | En Rust | |
|---|---|---|
| errores | un código de retorno (-1) y la variable global errno, fáciles de ignorar | Result<T, E>, que hay que mirar; ? lo propaga en un carácter |
| código genérico | macros del preprocesador o punteros void * sin tipo | genéricos y traits, comprobados por el compilador |
| tipos con variantes | un struct con una etiqueta y una union, a mano | enum con datos, y match avisa si falta un caso |
| cadenas | bytes terminados en un cero; medirlas es recorrerlas | longitud guardada y texto UTF-8 válido |
| dependencias y compilación | cabeceras .h, Make o CMake, sin gestor de paquetes | módulos y Cargo, que compila, prueba y descarga dependencias |
Ninguna de estas diferencias, por sí sola, justificaría cambiar de lenguaje. Juntas explican por qué quien se pasa a Rust por la seguridad suele quedarse por lo demás.
Lo que Rust no arregla
Rust no hace imposible todo lo anterior. Lo que promete es más preciso: un programa que no usa
unsafe no puede tener comportamiento indefinido.
unsafe es una marca que permite, dentro de un bloque, cinco cosas que el compilador no puede
comprobar: leer a través de un puntero crudo (uno sin reglas de préstamo, como los de C), llamar a
funciones marcadas como inseguras (entre ellas, todas las de C), tocar variables globales
modificables, y dos más de menor importancia. Hace falta para hablar con el hardware, para llamar a
código en C y para escribir algunas estructuras de datos. El propio Vec de la biblioteca estándar
usa unsafe por dentro para gestionar su bloque de memoria. La idea es que el unsafe quede
encerrado en piezas pequeñas, revisadas con cuidado, que ofrecen hacia fuera una interfaz segura.
Que esas piezas cumplan de verdad las reglas no es una cuestión de fe: el proyecto
RustBelt demostró formalmente, sobre un modelo del
lenguaje, que las reglas de Rust garantizan lo que prometen, incluidas bibliotecas como Arc o
Mutex, que usan unsafe por dentro. En Android, alrededor del 4 % del código en Rust está dentro
de bloques unsafe.
Y es en ese 4 % donde han aparecido los fallos. En 2025, Google estuvo a punto de publicar en
Android su primer fallo de memoria en Rust, un desbordamiento en un decodificador de imágenes
AVIF, dentro de código unsafe. Lo encontró antes de publicarlo, y el asignador de memoria de
Android habría impedido aprovecharlo de todas formas. En diciembre de 2025 llegó el
primer CVE del código en Rust de Linux: en el
controlador binder, que Android usa para comunicar procesos, un bloque unsafe quitaba elementos
de una lista suponiendo que ningún otro hilo la tocaba a la vez, y otro hilo sí la tocaba. Podía
colgar el sistema, no tomar el control de él.
Fuera de la memoria, Rust no promete nada, y hay cosas que deja pasar:
- Fugas de memoria. Para Rust, no liberar memoria es seguro: no es comportamiento indefinido. Dos valores que se apuntan entre sí con contadores de referencias no se liberan nunca.
- Paradas. Un panic en un servidor es una denegación de servicio, como el latido de antes: el programa no filtra la clave, pero deja de responder.
- Interbloqueos. Dos hilos que esperan cada uno el cerrojo del otro se quedan esperando para siempre, en Rust igual que en C. Rust impide las carreras de datos, no que el orden en que se hacen las cosas sea el correcto.
- Errores de lógica. El compilador comprueba que el programa no rompe la memoria, no que haga lo que tiene que hacer. Más abajo hay un ejemplo.
- Dependencias. Cargo hace tan fácil añadir bibliotecas que un proyecto mediano depende de cientos de ellas, escritas por gente a la que nadie ha revisado.
Quién lo está adoptando, y cómo
El caso mejor documentado es Android, y su lección más importante no es la que se espera. Hacia 2019, Google empezó a escribir el código nuevo de Android en lenguajes seguros con la memoria: Java y Kotlin donde se podía, y Rust en las partes de sistema que antes se escribían en C y C++. No reescribió el código viejo. Y aun así, la parte de las vulnerabilidades de Android que son fallos de memoria bajó así:
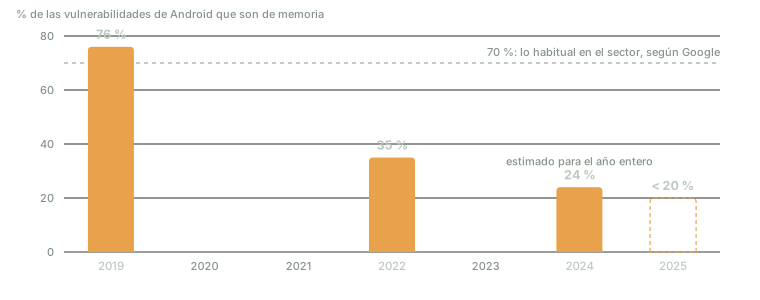
Fuente: el blog de seguridad de Google, entradas de diciembre de 2022, septiembre de 2024 y noviembre de 2025. Incluye el código en C y en C++ de Android.
La explicación es que las vulnerabilidades envejecen. Casi todas están en código escrito o modificado hace poco, y a medida que el código se usa, se prueba y se corrige, quedan menos. Según los datos de Google, el código de cinco años tiene entre 3,4 y 7,4 veces menos vulnerabilidades que el recién escrito. Si se deja de añadir código nuevo en C, el código en C que queda envejece, y sus fallos se agotan solos. Reescribir el código viejo, que es lo caro, es lo que menos rinde.
Google ha publicado otras dos cifras que vale la pena citar con cuidado. La primera es la densidad de fallos: cerca de mil fallos de memoria por cada millón de líneas en el C y C++ histórico de Android, frente a 0,2 en sus cinco millones de líneas de Rust. Ese 0,2 sale de un único fallo, el de AVIF, así que es una estimación muy gruesa, pero la distancia es de tres órdenes de magnitud. La segunda sorprendió más: los cambios medianos y grandes en Rust se deshacen por errores unas cuatro veces menos que los de C++, y pasan alrededor de un 25 % menos de tiempo en revisión. El código seguro, en Android, también es el que sale antes.
En el núcleo de Linux, Rust entró en la versión 6.1, en diciembre de 2022, como un experimento. En
la reunión anual de mantenedores de diciembre de 2025, el experimento se dio por concluido con
éxito: Rust se queda. Ya hay controladores escritos en él, como el binder de Android, y otros en
camino, como Nova, para las tarjetas gráficas de NVIDIA. El responsable del subsistema gráfico
calculaba entonces que en un año dejaría de aceptar controladores gráficos nuevos en C. Ubuntu
25.10, de octubre de 2025, cambió por defecto sudo y las utilidades básicas de la línea de órdenes
(ls, cp, date y el resto) por versiones escritas en Rust. Git ha anunciado que, a partir de su
versión 3.0, hará falta Rust para compilarlo.
Los gobiernos también empujan. En diciembre de 2023, las agencias de ciberseguridad de Estados Unidos (CISA y NSA) y de otros cuatro países publicaron una guía que pide a los fabricantes de software un plan para dejar los lenguajes sin seguridad de memoria. En octubre de 2024, CISA y el FBI fueron más lejos y pidieron que los productos ya escritos en esos lenguajes publicaran ese plan antes del 1 de enero de 2026. Son recomendaciones, no leyes, y no nombran un lenguaje: Java, C#, Go o Swift también son seguros con la memoria. Pero todos ellos gestionan la memoria por su cuenta mientras el programa se ejecuta: Java, C# y Go con un recolector de basura (garbage collector), que pausa el programa o gasta procesador cuando le conviene a él, y Swift contando referencias en cada asignación. En un núcleo de sistema operativo, un controlador o un microcontrolador, eso no es aceptable. Rust es el más maduro y extendido de los pocos lenguajes que ofrecen seguridad de memoria sin nada de eso, y por eso es el que está ocupando el sitio de C, no el de Java.
Lo que cuesta cambiar
Reescribir es arriesgado. El código viejo es feo, pero lleva dentro décadas de correcciones de
casos raros que nadie documentó. En octubre de 2025, recién publicada, Ubuntu 25.10 dejó de instalar
actualizaciones automáticas. La causa era la nueva versión en Rust de date: aceptaba la opción
-r, que da la fecha de modificación de un fichero, pero la ignoraba y devolvía la fecha actual. El
programa que decide si toca buscar actualizaciones compara la edad de un fichero, siempre le salía
cero y nunca tocaba. Es un error de lógica que el compilador de Rust no podía ver, y el tipo de
fallo que trae cualquier reescritura, en el lenguaje que sea.
La frontera entre C y Rust es trabajo. Un programa en Rust llama a C declarando las funciones
con extern "C", y cada llamada es unsafe, porque el compilador no puede comprobar lo que hace el
otro lado. Hay herramientas que generan esas declaraciones a partir de las cabeceras de C, pero lo
importante no está en las cabeceras: quién libera cada bloque, cuánto vive cada puntero, qué
función se puede llamar desde varios hilos. Alguien tiene que leer el código en C, entenderlo y
traducirlo a tipos de Rust. En Linux, eso abrió discusiones públicas y duras entre mantenedores
sobre quién arregla el lado de Rust cuando cambia una interfaz en C, y hubo quien dejó el proyecto
por ellas.
Dos compiladores en lugar de uno. El proyecto pasa a depender de dos cadenas de compilación, cada una con sus versiones. Y no todos los procesadores tienen las dos. El compilador de Rust usa LLVM para generar código, y gcc llega a arquitecturas a las que LLVM no llega. Cuando el responsable de APT, el gestor de paquetes de Debian, anunció en 2025 que pensaba hacer Rust obligatorio, los primeros afectados fueron las versiones de Debian para procesadores antiguos (m68k, Alpha, PA-RISC, SuperH), que no tenían un compilador de Rust en condiciones. Hay dos proyectos para que gcc compile Rust, y ninguno está terminado.
Certificar es caro. En aviones, coches o equipos médicos, el compilador tiene que estar certificado según normas como ISO 26262. Para C hay compiladores certificados desde hace décadas. Para Rust, el primero, Ferrocene, llegó en 2023. La especificación del lenguaje que hizo falta para certificarlo la escribió la misma empresa, y en 2025 la donó al proyecto Rust, que no tenía una.
Aprender lleva tiempo, aunque menos de lo que se dice. En una encuesta interna de Google a más de mil programadores que escribieron Rust en 2022, más de dos tercios se sentían capaces de contribuir a un proyecto en Rust en dos meses o menos. Un tercio era tan productivo como en su lenguaje anterior en ese tiempo, y más de la mitad en cuatro meses.
Los inconvenientes de Rust frente a C
Además de lo que cuesta el cambio, Rust tiene inconvenientes propios, que seguirían ahí en un proyecto empezado desde cero.
El comprobador de préstamos rechaza programas correctos. Es conservador: si no puede demostrar
que un programa es seguro, lo rechaza, aunque lo sea. Las estructuras en las que muchas partes
apuntan unas a otras (grafos, listas doblemente enlazadas, árboles cuyos nodos conocen a su padre)
chocan de frente con la regla de un solo dueño. En C, una lista doblemente enlazada son veinte
líneas. En Rust hay un libro entero dedicado a
escribir listas enlazadas, y la doblemente enlazada acaba usando unsafe o contadores de
referencias. La solución habitual es otra forma de pensar: guardar los nodos en un vector y que se
apunten por índice. Funciona, pero hay que aprenderla.
Compila despacio. Con un programa de cinco líneas no se nota: gcc tarda 0,10 segundos y rustc, 0,15. Con un proyecto grande sí. Rust genera una copia del código de cada función genérica para cada tipo con el que se usa, el comprobador de préstamos trabaja, y las dependencias se compilan desde el código fuente. En la encuesta de Google, la lentitud al compilar era, con mucha diferencia, la queja número uno, y en la encuesta anual del propio proyecto Rust sigue encabezando la lista de problemas de productividad.
Los ejecutables son más grandes. El programa que imprime «hola» ocupa 15 952 bytes en C y 4 536 368 en Rust, que bajan a 336 744 al quitarle la información de depuración. La diferencia es que el programa en C usa la biblioteca estándar que ya está instalada en el sistema, y el de Rust lleva dentro la suya. En un servidor da igual. En un microcontrolador con 64 KB de memoria, no, y por eso Rust permite prescindir de la biblioteca estándar, a cambio de renunciar a buena parte de lo que trae.
No tiene un ABI estable. La forma en que Rust organiza los datos y pasa los argumentos puede
cambiar entre versiones del compilador. Una biblioteca en Rust que tenga que llamarse desde otro
lenguaje, o desde Rust compilado con otra versión, tiene que exponer funciones con la convención de
C (extern "C") y datos dispuestos como en C (#[repr(C)]). Rust, para hablar con el mundo,
también habla C.
Hay un solo compilador de verdad. C tiene gcc, clang, el de Microsoft y docenas de compiladores
para microcontroladores, y una norma ISO que dice qué deben hacer. Rust tiene rustc, y su
especificación oficial es de 2025. Para la mayoría de los proyectos no importa. Para los que
necesitan dos implementaciones independientes, o un compilador para un procesador raro, sí.
Quien quiera algo más cercano a C, sin el comprobador de préstamos, tiene
Zig: un lenguaje pequeño, que compila C y se mezcla con él sin fricción,
comprueba los índices en sus modos de compilación seguros y no tiene NULL implícito, pero no
impide el uso tras liberar ni las carreras de datos. Lo usan proyectos como Bun, TigerBeetle o
Ghostty, aunque en 2026 todavía no ha llegado a su versión 1.0 y cada versión nueva suele romper
código de la anterior.
Cuándo elegir cada uno
La pregunta útil no es «¿C o Rust?» en general, sino para qué código.
| situación | elección | por qué |
|---|---|---|
| código que lee datos de fuera: protocolos de red, formatos de fichero, analizadores | Rust | es donde están casi todas las vulnerabilidades |
| un proyecto nuevo que vivirá años y tendrá muchos autores | Rust | el compilador vigila lo que nadie recuerda dentro de cinco años |
| concurrencia intensa | Rust | las carreras de datos son errores de compilación |
| un proyecto grande que ya está en C | C, y Rust en lo nuevo | reescribir lo viejo es lo que menos rinde |
| un microcontrolador cuyo fabricante sólo da un compilador de C | C | no hay otra opción realista |
| una biblioteca que van a llamar muchos lenguajes | interfaz en C | la implementación puede ser Rust |
| aprender cómo funciona la memoria | C | Rust esconde, a propósito, lo que hay que ver |
Hay casos en los que la respuesta no es ninguno de los dos. Si un recolector de basura es aceptable, como en casi cualquier servicio de red o herramienta de línea de órdenes, Go es más sencillo que ambos, y es en lo que están escritos Docker y Kubernetes.
Y si hay que quedarse en C, se puede escribir un C bastante más seguro: compilar con -Wall -Wextra
y tratar los avisos como errores, pasar las pruebas con -fsanitize=address,undefined (y thread
si hay hilos), probar con entradas generadas al azar (fuzzing), y compilar lo que se publica con
las protecciones del compilador (-fhardened en gcc 14 o posterior). Ninguna de esas medidas
convierte C en un lenguaje seguro, pero los cinco ejemplos de este artículo los habría detectado
alguna.
Cómo evoluciona C
C no está parado. Lo que pasa es que cambia despacio, a propósito: su valor está en que el código de hace cuarenta años siga compilando, y en que haya un compilador para cada procesador, así que cada novedad tiene que convencer a quienes mantienen docenas de compiladores.
El primer intento serio de la norma de atacar los desbordamientos salió mal. C11 añadió un anexo
opcional con versiones de las funciones de cadenas que reciben el tamaño del destino (strcpy_s,
memcpy_s y compañía). Cuatro años después, un
informe para el propio comité
constataba que casi nadie las había implementado, que la biblioteca de C de Linux las había
rechazado varias veces y que el código que las usaba no salía más seguro, y proponía quitarlas.
C23, la norma publicada en 2024, es la revisión más grande desde 1999, y varias de sus novedades
apuntan a los problemas de este artículo: nullptr, un puntero nulo con tipo propio;
[[nodiscard]], para que el compilador avise si se ignora el valor que devuelve una función; los
enteros con signo pasan a ser obligatoriamente de complemento a dos (aunque desbordarlos sigue
siendo comportamiento indefinido), y llega
<stdckdint.h>, con sumas, restas y
multiplicaciones que dicen si se han desbordado. Con ella, la función del ejemplo queda bien:
#include <stdckdint.h>

int cabe(int x, int y) {
    int suma;
    return !ckd_add(&suma, x, y);     /* ckd_add devuelve true si se ha desbordado */
}
Devuelve 0 con INT_MAX y 1, con y sin optimizaciones. La próxima revisión, que el comité llama
C2y mientras no tenga año, ya incluye _Countof, que da el número de elementos de un array sin
el truco de dividir tamaños con sizeof, que falla en silencio cuando el array ya es un puntero. Y
defer, para que una función libere sus recursos al salir sin repetir el free en cada return,
avanza como especificación técnica aparte, un documento que los compiladores pueden implementar
antes de que entre en la norma.
Fuera de la norma, la evolución es más rápida. Los compiladores añaden protecciones: -fhardened
activa de una vez las comprobaciones de las funciones de cadenas, la protección de la pila y otras
más. Fil-C es un compilador de C que hace seguro con la memoria el C de
siempre, casi sin cambiar el código, con un recolector de basura y comprobaciones en cada acceso, a
cambio de un programa más lento (entre una y cuatro veces, según las mediciones publicadas). Y el
hardware se ha puesto a ayudar. El etiquetado de memoria de ARM (MTE), que los Pixel ofrecen desde
el Pixel 8 y Apple activa en el iPhone 17, marca cada bloque y cada puntero con una etiqueta y
detiene el programa cuando no coinciden. Y los procesadores con
CHERI, todavía casi todos experimentales,
convierten cada puntero en una capacidad que lleva sus propios límites.
Todas estas medidas tienen algo en común: detectan el error mientras el programa se ejecuta, o lo hacen más difícil de aprovechar. Ninguna lo impide al compilar, como el comprobador de préstamos. Y C no puede añadir uno sin romper casi todo el C que existe, porque casi todo el C que existe comparte y libera memoria de formas que esas reglas prohíben. Un C con préstamos sería otro lenguaje.
¿Va a desaparecer C?
Hay un precedente. C++ nació a principios de los ochenta como un C mejor, compatible con él, con la intención explícita de sustituirlo. Cuarenta años después, C sigue aquí, y C++ comparte sus problemas de memoria. Fortran y COBOL, más viejos que C, siguen ejecutándose en bancos y en centros de cálculo, y los dos tuvieron norma nueva en 2023. Los lenguajes con mucho código detrás no mueren: dejan de usarse para empezar cosas.
C tiene, además, tres razones para quedarse que los otros no tenían.
Es el idioma común. Mientras los sistemas operativos publiquen sus servicios como funciones de C, y los lenguajes se llamen unos a otros a través del ABI de C, C seguirá existiendo aunque nadie escriba un programa entero en él. Rust, para hablar con el mundo, habla C.
El código que existe no compensa reescribirlo. Es la lección de Android: el código viejo, si no se toca, se vuelve más seguro con los años. Lo que rinde es escribir lo nuevo en otro lenguaje, y eso deja miles de millones de líneas de C funcionando durante décadas, con alguien que tiene que mantenerlas.
Hay sitios a los que Rust no llega. Microcontroladores de 8 bits, procesadores de señal con un compilador del fabricante, entornos certificados donde cambiar de compilador cuesta años. Ahí C no compite con Rust. Compite con el ensamblador.
Lo que sí va a cambiar es qué se escribe en C. El código que lee datos de fuera, el que más vulnerabilidades produce, se está yendo a Rust, empujado por Google, por Microsoft, por Linux y por los reguladores. C va camino de ocupar el sitio del ensamblador: nunca desapareció, sigue debajo de todo, pero lo escriben menos personas, para tareas concretas, sabiendo por qué.
Y C evoluciona, aunque no para dejar de ser C. Las novedades de C23 y C2y quitan aristas, las herramientas detectan más errores y el hardware hace más difícil aprovecharlos. Nada de eso le da lo que tiene Rust, porque lo que tiene Rust es justo lo que C decidió no tener: un compilador que no confía en el programador.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: los fallos de memoria de C no son descuidos de programadores malos. Son la consecuencia de que el lenguaje deje en manos del programador cuánto mide cada bloque, cuánto vive y quién lo toca a la vez, y de que el compilador dé por hecho que no se ha equivocado. Rust no hace mejores a los programadores, hace que el compilador compruebe esos tres hechos, y el precio es aprender a escribir programas que el compilador pueda comprobar.
Y si te llevas tres cosas más, que sean prácticas.
Si escribes C, pasa las pruebas con los sanitizers. -fsanitize=address,undefined habría
encontrado cuatro de los cinco errores de este artículo, y -fsanitize=thread el quinto. Cuestan
una línea en la compilación de las pruebas.
Escribe en Rust el código nuevo que lee datos de fuera. Un analizador, un protocolo, un formato de fichero. Es donde están los fallos que se aprovechan, y donde Rust se nota más.
No reescribas lo que funciona sólo por reescribirlo. El código viejo en C, si no se toca, cada año tiene menos fallos. Escribe lo nuevo en Rust, cuida la frontera entre los dos, y deja que el C envejezca.
C lleva cincuenta años confiando en el programador, y durante la mayor parte de ese tiempo era la única forma de escribir software de sistemas que fuera rápido. Ya no lo es. Lo que no va a desaparecer es la necesidad de entender lo que C enseña: qué es una dirección, cuánto vive un bloque de memoria, qué pasa cuando dos hilos tocan lo mismo. Rust no hace que eso deje de importar. Sólo hace que el compilador lo compruebe por ti.