 Por Gustavo Torres
AWS Lambda es el servicio de la nube de Amazon, Amazon Web Services (AWS), para ejecutar código sin tener un servidor propio. Le subes un fichero con tu código, te da una dirección web, y cada vez que llega una petición a esa dirección, AWS ejecuta el código en una de sus máquinas y devuelve lo que conteste. AWS llama función a todo ese código, aunque dentro haya más cosas. En Python, lo único obligatorio es una función normal, el handler (manejador), que Lambda llama una vez por cada petición. El resto del fichero se ejecuta antes, una sola vez, cuando Lambda prepara una copia del código para atender peticiones: lo que en este artículo llamo una instancia.
Éste es el fichero que he subido. La parte de arriba, que se ejecuta al arrancar la instancia,
genera un identificador (INSTANCIA) y anota la hora. El handler, lambda_handler, cuenta cuántas
peticiones lleva atendidas esa instancia y devuelve las tres cosas. El parámetro espera, que se le puede pasar en la dirección
(?espera=1) para que duerma unos segundos, lo usaré más adelante.
import time
import uuid

# Esto se ejecuta una sola vez, cuando la instancia arranca.
INSTANCIA = uuid.uuid4().hex[:8]
CREADA = time.time()
llamadas = 0


def lambda_handler(event, context):
    # Y esto, en cada petición.
    global llamadas
    llamadas += 1
    espera = float((event.get("queryStringParameters") or {}).get("espera", 0))
    time.sleep(espera)
    return {"instancia": INSTANCIA, "llamadas": llamadas,
            "edad_s": round(time.time() - CREADA, 1)}
He llamado a la función dos veces seguidas desde mi portátil con curl usando la opción -w,
que le pide que escriba cuánto tardó la petición entera desde que empieza a conectar hasta que recibe el último byte:
$ curl -s -w '  %{time_total} s\n' https://…lambda-url.eu-west-1.on.aws/
{"llamadas":1,"instancia":"f6bbe1bf","edad_s":0.0}  0.508480 s
$ curl -s -w '  %{time_total} s\n' https://…lambda-url.eu-west-1.on.aws/
{"llamadas":2,"instancia":"f6bbe1bf","edad_s":0.3}  0.254230 s
La primera petición tardó 0,51 s, y la segunda, la mitad. Las dos las contestó la misma instancia:
el identificador es el mismo, f6bbe1bf, y su contador pasó de 1 a 2. Lambda apunta en su registro
una línea por cada petición, con lo que midió por dentro, y ahí está la diferencia (recortado):
Duration: 2.40 ms   Billed Duration: 115 ms   Init Duration: 111.69 ms
Duration: 1.55 ms   Billed Duration: 2 ms
Duration es lo que tardó el handler: unos 2 ms las dos veces. Init Duration sólo aparece en la
primera, porque antes de esa petición f6bbe1bf no existía. Lambda tuvo que crearla: una máquina
virtual pequeña, un intérprete de Python y el código global que genera el
identificador (112 ms). Billed Duration es lo que me cobró: 115 ms la primera vez y 2 la segunda.
Y antes de todo eso hubo más trabajo, que el registro ni siquiera menciona. Para la segunda
petición, la instancia ya estaba hecha.
Ésa es, en pequeño, la idea entera. Serverless no quita los servidores. Quita la decisión de cuántos tener encendidos, y cobra sólo por el tiempo que trabajan. El precio es que el servidor nace cuando llega una petición y muere cuando deja de haberlas, y tu código tiene que estar escrito para una máquina que en cualquier momento puede no existir. De esa frase sale todo lo demás: el malentendido del nombre, el problema que resuelve, el arranque en frío, lo que cambia en el código y cuándo sale más caro que un servidor de toda la vida.
La palabra servidor tiene dos sentidos, y conviene separarlos. Uno es la máquina, física o virtual, con su procesador, su memoria y su sistema operativo. El otro es el programa que espera peticiones y las contesta, como un servidor web. Una instancia de Lambda es las dos cosas en pequeño: una copia en marcha de tu código y la máquina que la sostiene. Lo que no hay, de tu lado, es nadie que la encienda, la dimensione o la apague.
Todos los resultados del artículo están medidos. Los ejemplos que no aparecen enteros enlazan a su
código, y un script crea las funciones en una cuenta de AWS, las llama,
lee sus registros y lo borra todo al terminar, así que cualquiera puede repetirlo. Las medidas son
del 17 de octubre de 2026, en la región de Irlanda (eu-west-1), con Python 3.14 y 128 MB de
memoria salvo donde digo otra cosa.
El problema: pagar por una máquina que casi siempre espera
Con un servidor tradicional, alquilado o propio, decides de antemano cuánta máquina necesitas. Si eliges para el tráfico normal, el día del pico se cae. Si eliges para el pico, el resto del tiempo pagas una máquina que espera. Y el tráfico casi nunca es plano: hay día y noche, semanas con campaña y semanas sin ella, y muchas aplicaciones pasan horas sin una sola petición.
No es un caso raro. Cuando Luiz André Barroso y Urs Hölzle, de Google, midieron más de 5 000 servidores durante seis meses, la mayor parte del tiempo estaban entre el 10 y el 50 % de su capacidad: casi nunca parados, casi nunca llenos. Y del lado de las aplicaciones pequeñas, cuando Microsoft estudió dos semanas de tráfico real de su servicio de funciones, el 45 % de las aplicaciones se invocaba, de media, una vez por hora o menos. Con un servidor por aplicación, casi todo ese hierro estaría encendido para nada.
El segundo problema es el trabajo de tenerlo. Un servidor hay que instalarlo, actualizar su sistema operativo, parchear los fallos de seguridad, vigilar que no se llene el disco y decidir cuándo añadir otro. Se puede automatizar mucho (el autoescalado de las nubes arranca máquinas virtuales cuando sube la carga), pero alguien tiene que diseñar esa automatización, y una máquina virtual nueva tarda minutos en estar lista.
Conviene tener los dos problemas separados, el de pagar capacidad ociosa y el de operar máquinas, porque serverless ataca los dos, y no los resuelve igual de bien.
De dónde viene
La idea de arrancar el código cuando llega la petición es casi tan vieja como la web. En 1993,
CGI (Common Gateway Interface), del servidor web
del NCSA, dejaba que una página la generara un programa cualquiera: por cada petición, el servidor
web arrancaba un proceso nuevo, le pasaba los datos, recogía lo que imprimía y lo dejaba morir. Era
simple y lento, porque arrancar un proceso por petición cuesta. En 1996, FastCGI resolvió la
lentitud con lo contrario: mantener el proceso vivo entre peticiones. Es el mismo dilema que el de
la instancia f6bbe1bf, treinta años antes.
En 2006, Amazon lanzó EC2 (Elastic Compute Cloud), el servicio de su nube, AWS, que alquila máquinas virtuales por horas: ordenadores simulados por software, que se reparten un servidor físico con otros sin verse entre sí. Ya no había que comprar hierro, pero seguía habiendo máquinas: las elegías, las administrabas y las pagabas encendidas, trabajaran o no. En 2008, Google App Engine fue un paso más allá: subías tu aplicación en Python, y Google decidía cuántas copias ejecutar. A este modelo se le llama PaaS (Platform as a Service, plataforma como servicio), frente al IaaS (Infrastructure as a Service) de EC2, y tenía su precio en libertad: App Engine sólo admitía ciertos lenguajes y no dejaba, por ejemplo, escribir en el disco.
Hacia 2011, Parse y Firebase ofrecieron a las aplicaciones móviles un servidor ya hecho: base de datos, usuarios y notificaciones detrás de una API, sin escribir código de servidor. Es el BaaS (Backend as a Service, servidor como servicio). Y en 2012, Ken Fromm, de Iron.io, una empresa que vendía colas y procesos en la nube, escribió el artículo que popularizó la palabra serverless, avisando ya en el texto de que no significaba que no hubiera servidores, sino que el programador dejaba de pensar en ellos.
El 13 de noviembre de 2014, Amazon presentó AWS Lambda en versión preliminar. Sólo admitía Node.js, y las funciones se disparaban con eventos de otros servicios de AWS: un fichero nuevo en S3, su almacén de ficheros, o un cambio en una tabla de DynamoDB, su base de datos. Lo nuevo no era ejecutar código ajeno, que App Engine ya hacía. Era la unidad: no había instancias que configurar ni que pagar, sino una función que se ejecuta cuando ocurre un evento, facturada por peticiones y por tiempo de ejecución en tramos de 100 ms. Si no pasaba nada, no costaba nada. En julio de 2015, API Gateway puso una dirección web delante de las funciones, y con ella se podía construir una API entera. En 2016 llegaron Google Cloud Functions y Azure Functions.
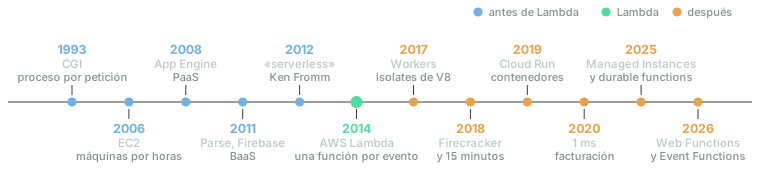
No a escala. Lambda no inventó ejecutar código ajeno; inventó cobrarlo por petición y por milisegundo, sin instancias a la vista.
Qué significa «serverless», y qué no
El nombre engaña a propósito. Las funciones de Lambda se ejecutan en una flota de servidores de AWS, cada uno con muchas funciones de muchos clientes a la vez. Lo que desaparece no es la máquina, es la máquina como algo que tú eliges, dimensionas, parcheas y pagas por horas. Ken Fromm ya lo decía en 2012, y Mike Roberts, en el texto de referencia sobre el tema, lo resume igual: los servidores siguen ahí, sólo que los gestiona otro.
Es más útil definirlo por lo que hace que por lo que ejecuta. Un servicio es serverless si cumple cuatro cosas:
- No aprovisionas ni administras máquinas. No eliges tamaño de servidor, ni sistema operativo, ni cuántas copias.
- Escala solo con la demanda, también hasta cero. Con diez peticiones a la vez hay diez instancias; sin peticiones, ninguna.
- Pagas por uso, no por capacidad reservada. Peticiones, milisegundos, bytes guardados.
- Las instancias son efímeras. Como pueden nacer y morir en cualquier momento, no puedes guardar nada importante en ellas.
La última no es una promesa, es una consecuencia de las otras tres, y es la que más cambia la forma de programar. El informe de Berkeley de 2019, el que fijó buena parte del vocabulario, compara el salto con el de pasar de ensamblador a un lenguaje de alto nivel: el programador deja de gestionar un recurso (allí, los registros; aquí, las máquinas) y el sistema lo hace por él.
Alrededor de la palabra han crecido varios términos que se mezclan a menudo:
| Término | Qué gestionas tú | Cómo pagas | ¿Baja a cero? |
|---|---|---|---|
| IaaS: máquinas virtuales (EC2) | Sistema operativo, programa, escalado y código | Por hora encendida | No |
| PaaS: una plataforma que ejecuta tu aplicación (Heroku, App Engine) | Código y, a menudo, cuántas copias | Por instancia y hora | Depende |
| FaaS: funciones que se disparan con eventos (Lambda, Cloud Functions) | Código | Por petición y milisegundo | Sí |
| BaaS: servicios hechos que sustituyen código tuyo (Firebase, Auth0) | Configuración | Por uso | Sí |
| Contenedores serverless (Cloud Run, Fargate) | La imagen del contenedor | Por uso o por tarea | Cloud Run sí, Fargate no |
| Funciones en el borde: código cerca del usuario (Cloudflare Workers) | Código | Por petición y CPU | Sí |
FaaS (Function as a Service, función como servicio) y BaaS son las dos patas originales del término, y por eso «serverless» y «Lambda» se usan a veces como sinónimos, aunque no lo son. Un contenedor es una forma de empaquetar un programa con todo lo que necesita para ejecutarse (sus bibliotecas, su configuración) y aislarlo de los demás programas de la máquina; Cloud Run ejecuta contenedores cuando llegan peticiones y los apaga cuando dejan de llegar. Fargate también ejecuta contenedores sin que veas máquinas, pero cobra mientras la tarea está en marcha, haya peticiones o no. Ahí empieza el serverless-washing: llamar serverless a todo lo que esconde una máquina, aunque no escale a cero ni cobre por uso.
La frontera con el PaaS es la más borrosa, y la mejor prueba sigue siendo la que Roberts atribuye a Adrian Cockcroft: si tu plataforma puede arrancar instancias en 20 ms que funcionan medio segundo, llámala serverless. Lo que separa a Lambda de Heroku no es el código que se sube, es la granularidad: instancias que nacen para una petición y una factura que llega al milisegundo.
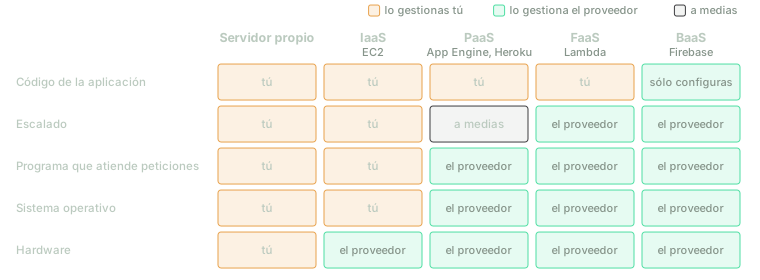
De izquierda a derecha, el proveedor se queda con más capas. Serverless empieza donde dejas de decidir cuántas máquinas hay.
Cómo funciona por dentro
Para ver el mecanismo uso Lambda, porque es la plataforma mejor documentada y porque AWS ha publicado cómo está construida por dentro. Desde el 12 de octubre de 2026, AWS llama a estas funciones clásicas Lambda Event Functions, para distinguirlas de un producto nuevo del que hablaré al final. Las demás plataformas funcionan de forma parecida, con las diferencias que iré señalando.
Una función, un evento
El handler del principio recibe dos argumentos, event y context. El evento es un JSON que
describe lo que ha pasado, y el contexto trae datos de la invocación, como su identificador o la
memoria disponible. Lo que ha pasado puede ser una petición HTTP que llega
por una Function URL (la
dirección web gratuita que da Lambda, como la del principio) o por API Gateway, un fichero subido a
S3, un mensaje en una cola, o un temporizador que dispara la función cada hora.
Las invocaciones son de dos tipos. En una síncrona, quien llama espera la respuesta; es lo que hace una petición HTTP. En una asíncrona, Lambda guarda el evento en una cola propia, contesta enseguida que lo ha recibido y ejecuta la función después, reintentando si falla. Las dos diferencias importan más adelante.
La primera petición: el arranque en frío
Cuando llega una petición, Lambda busca una instancia de esa función que ya esté preparada y libre. AWS las llama execution environments (entornos de ejecución), y en el artículo de Firecracker, slots: huecos en un servidor de AWS que sirven a una sola función y a una sola petición a la vez, y se reutilizan para muchas peticiones seguidas. Si hay uno libre, la petición va allí. Si no, Lambda crea uno: elige un servidor, arranca en él una máquina virtual mínima, le copia tu código, arranca el intérprete de Python y todo lo que está fuera del handler. Sólo entonces llama al handler. Esa preparación es el arranque en frío (cold start); una petición que encuentra la instancia hecha es una petición en caliente.
Al terminar, Lambda congela la instancia: pausa sus procesos y la conserva, con su memoria, por
si llega otra petición. La documentación lo cuenta en su
descripción del ciclo de vida,
con tres fases: Init (preparar), Invoke (atender cada petición) y Shutdown (morir).
He forzado veinte arranques en frío de la función del principio (cambiar su configuración obliga a Lambda a tirar las instancias que tenía) y he hecho tres peticiones en caliente después de cada uno. Las medianas:
| Arranque en frío | Petición en caliente | |
|---|---|---|
| Tiempo total, visto desde el portátil | 0,51 s | 0,24 s |
| … de ellos, abrir la conexión (TCP y TLS) | 0,17 s | 0,17 s |
| … desde la conexión hasta el primer byte de la respuesta | 0,33 s | 0,08 s |
Init Duration: preparar la instancia, según Lambda | 116 ms | (no hay) |
Duration: el handler | 2,3 ms | 1,7 ms |
Billed Duration: lo que se cobra | 119 ms | 2 ms |
Abrir la conexión cifrada hasta Irlanda cuesta lo mismo en los dos casos, y los 80 ms de la petición
caliente son casi todos red: el handler trabaja menos de 2 ms. El arranque en frío añade unos
250 ms en el servidor. De ellos, 116 son el Init que Lambda registra (arrancar Python e importar el
fichero); los otros 130, más o menos, son lo que pasa antes, crear la máquina virtual y colocar el
código, que no aparece en el registro.
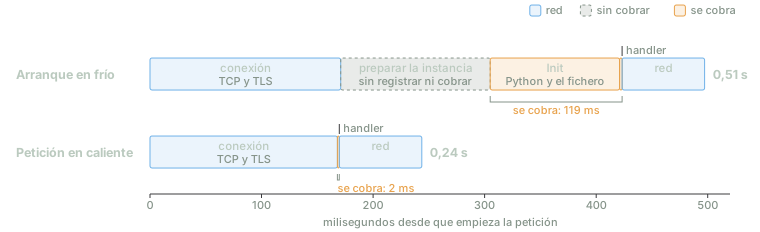
Medianas de veinte arranques en frío y sesenta peticiones en caliente. Desde agosto de 2025, el Init se cobra; lo que pasa antes, no.
Ese Init se cobra. Hasta el 1 de agosto de 2025 no se cobraba en las funciones como ésta (paquete
.zip y un lenguaje de los que gestiona AWS); desde entonces,
se factura como el resto,
y por eso la primera petición costó 119 ms y la segunda 2. Lo que pasa antes del Init sigue sin
cobrarse.
Lo que alarga el arranque
Lo que haces en el Init, lo pagas en cada instancia nueva, en tiempo y en dinero. He medido diez
arranques en frío de cuatro variantes de la misma función:
| Variante | Paquete | Init | Hasta el primer byte |
|---|---|---|---|
| La función tal cual | 440 bytes | 114 ms | 0,35 s |
… más import boto3 (la biblioteca de AWS para Python) | 479 bytes | 364 ms | 0,58 s |
| … con pandas dentro del paquete, sin importarlo | 43 MB | 113 ms | 0,58 s |
| … con pandas, importado | 43 MB | 2 821 ms | 3,27 s |
Importar boto3, que viene ya instalada en Lambda, cuesta un cuarto de segundo. Importar
pandas, la biblioteca de tablas de datos de Python, casi tres. Y el
tamaño del paquete cuesta aunque no lo uses: 43 MB que nadie importa no tocan el Init, pero
retrasan la respuesta unos 200 ms, el tiempo de colocar el código antes de arrancar nada. Ese tiempo
no sale en el registro ni en la factura, pero el usuario lo espera. Con 1769 MB de memoria las cifras
son las mismas: la memoria, que en Lambda decide cuánta CPU tienes (lo veremos más abajo), no
acelera el arranque. AWS no documenta por qué.
Los tres segundos de pandas tienen una historia. En mi portátil, import pandas tarda 0,5 s; en
Lambda, incluso con la instancia caliente y los ficheros ya leídos, tarda 2 s. La causa está en los
.pyc, los ficheros donde Python guarda el código ya compilado para no compilarlo cada vez. Cada
.pyc anota la fecha de modificación del fichero fuente, y Python sólo lo usa si la fecha coincide.
Pero el formato .zip guarda las fechas en hora local, sin zona horaria y en segundos pares, y Lambda
las lee como si fueran hora UTC. Mi portátil está en UTC+2, así que en Lambda cada fichero de pandas
parecía dos horas más nuevo que su .pyc. Python los descartó todos (sólo los de pandas son 1 421) y
recompiló la biblioteca entera. En un servidor normal eso pasaría una vez: Python guardaría los .pyc nuevos y el
siguiente arranque sería rápido. En Lambda, el directorio del código es de sólo lectura, así que
lo que un servidor hace una vez, Lambda lo repite en cada instancia nueva.
El arreglo es una opción de Python 3.7 en adelante
(PEP 552): compilar los .pyc para que se validen por un hash
del código en vez de por la fecha.
python -m compileall -q -f --invalidation-mode unchecked-hash paquete/Con eso, el Init de pandas baja de 2,7 s a 1,0 s, y la respuesta completa, de 3,3 s a 1,7 s. La
lección general no es sobre pandas: en una función, todo lo que se ejecuta al arrancar se ejecuta
muchas veces, y lo que en un servidor sería una molestia de un día se convierte en una parte fija
de la latencia y de la factura.
Cuánto vive una instancia sin trabajo
Si la instancia se conserva entre peticiones, ¿durante cuánto tiempo? AWS no lo dice. La documentación sólo explica que la mantiene «durante un tiempo», a la espera de otra invocación, y que de todas formas la sustituye cada pocas horas, aunque reciba peticiones sin parar.
Así que lo he medido. He creado quince copias de la función del principio, cada una con un hueco
fijo, de 1 a 90 minutos, y durante cinco o seis horas cada una ha repetido el mismo ciclo: la llamo,
espero su hueco sin hacerle ninguna petición y la vuelvo a llamar. Si contesta la misma instancia
(el mismo identificador), ha sobrevivido al hueco; si contesta otra, Lambda la había retirado. Cada
copia es una función distinta, así que sus instancias no se mezclan, y cada prueba cuenta por el
hueco que hubo de verdad, medido en el portátil
(el experimento, medir.py vida).
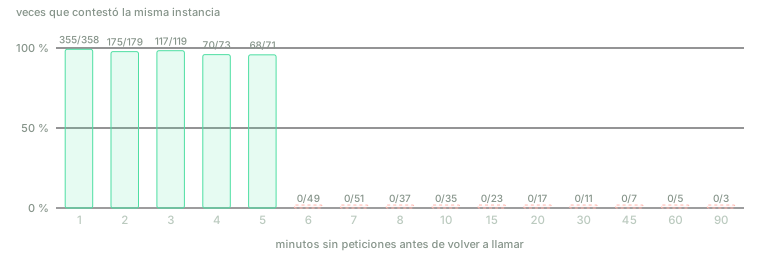
Quince funciones, cada una llamada con un hueco fijo durante cinco o seis horas. Hasta cinco minutos sin peticiones, la instancia sigue ahí casi siempre; desde seis, nunca.
El corte es nítido. Con cinco minutos o menos sin peticiones, contestó la misma instancia 785 veces de 800. Con seis o más, ninguna de 238. La frontera está justo ahí: a los cinco minutos sobrevivió 68 veces de 71, y a los seis, 0 de 49. En mi cuenta, en esta región y este día, Lambda retira una instancia ociosa entre los cinco y los seis minutos.
De las quince veces que una instancia desapareció con cinco minutos o menos de espera, diez le llegaron a instancias con más de dos horas de vida, entre 123 y 144 minutos, que recibían una petición cada pocos minutos y nunca llegaban a estar ociosas. Es la renovación «cada pocas horas» de la documentación, que aquí fue a las dos horas y poco: ninguna instancia pasó de 144 minutos, por mucho trabajo que tuviera. Las otras cinco le llegaron a instancias más jóvenes, sin una causa que se vea desde fuera.
Ninguna de las dos cifras está documentada, así que AWS puede cambiarlas cuando quiera, y no hay que construir nada que dependa de ellas. Pero explican cuándo hay arranques en frío. Una función con tráfico constante casi nunca los tiene: AWS calcula que ocurren en menos del 1 % de las invocaciones. Una que recibe una petición cada diez minutos los tiene en todas.
Una petición por instancia: cómo escala
Cada instancia de Lambda atiende una sola petición a la vez. Si llegan diez a la vez, hacen falta
diez instancias. He lanzado varias tandas de peticiones contra la función del principio, pidiéndole
que durmiera un segundo en cada una (el parámetro espera) para que se solaparan:
| Tanda | Respuestas | Instancias distintas | Arranques en frío |
|---|---|---|---|
| 10 peticiones, una detrás de otra | 10 | 1 | 1 |
| 10 a la vez | 10 | 10 | 10 |
| Otras 10 a la vez, justo después | 10 | 10 (las mismas) | 0 |
| 20 a la vez | 10, y 10 rechazadas | 10 | 0 |
| 10 una detrás de otra | 10 | 1 | 0 |
Diez peticiones seguidas las atiende una sola instancia, que se reutiliza. Diez a la vez crean diez
instancias, cada una con su arranque en frío; la siguiente tanda las reutiliza todas. Y veinte a la
vez chocan con un límite: mi cuenta, nueva, sólo puede tener diez instancias en marcha a la vez, y
Lambda rechazó las otras diez en 0,3 s con un error 429 (Rate Exceeded). AWS da por defecto
1 000, pero las cuentas
nuevas empiezan con menos y lo suben con el uso.
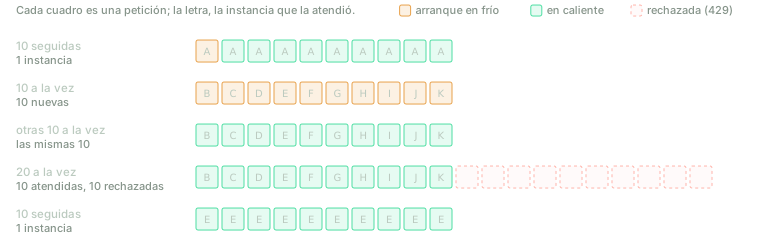
Una instancia por petición en curso, nunca dos peticiones en la misma. El límite de la cuenta es el número de instancias a la vez, no el de peticiones por segundo.
Por eso, en Lambda, la cuenta que importa es la concurrencia: peticiones por segundo por segundos que dura cada una. Cien peticiones por segundo que tardan 50 ms necesitan unas cinco instancias. Cien por segundo que esperan un segundo a una base de datos necesitan cien. La espera ocupa una instancia entera, aunque no use la CPU.
Una máquina virtual por función
Tu código se ejecuta en los mismos servidores físicos que el de otros clientes de AWS, así que el aislamiento entre ellos es lo primero. Al principio, Lambda metía las funciones en contenedores, y los contenedores de cada cliente en máquinas virtuales separadas. Al equipo no le gustaba: un contenedor comparte el núcleo del sistema operativo con los demás programas de la máquina, y un fallo en ese núcleo es un fallo de aislamiento. Una máquina virtual completa no comparte núcleo, pero era demasiado pesada para crear una por función.
La respuesta fue Firecracker, publicado en 2018: un gestor de máquinas virtuales recortado al mínimo, sin BIOS ni dispositivos que una función no necesita. Según el artículo que lo describe, cada microVM ocupa menos de 5 MB además de la memoria de la función, arranca hasta el código de la aplicación en menos de 125 ms, y un mismo servidor puede crear hasta 150 por segundo. Cada slot de Lambda es una de ellas. Arrancarla y copiarle el código es lo que ocurre en los 130 ms sin registrar de la medida de antes, aunque AWS no detalla cuánto se lleva cada cosa.
Cloudflare tomó el camino contrario. Workers no crea una máquina virtual por función, sino un isolate de V8, el motor de JavaScript de Chrome: muchos programas aislados dentro de un mismo proceso, como las pestañas de un navegador. Arrancan en unos 5 ms y caben miles en un proceso, a cambio de ejecutar sólo JavaScript y WebAssembly. Es el mismo intercambio de siempre: cuanto menos aislamiento y menos compatibilidad, más rápido el arranque.
Cómo se cobra
Lambda cobra dos cosas: 0,20 dólares por cada millón de peticiones, y el tiempo de ejecución multiplicado por la memoria configurada, en GB-segundos: una función de 1 GB que trabaja un segundo gasta un GB-segundo, que en Irlanda cuesta 0,0000166667 dólares (un 20 % menos con procesadores Arm). Cada mes, el primer millón de peticiones y los primeros 400 000 GB-segundos son gratis.
La memoria es la palanca que lo mueve todo, porque Lambda reparte la CPU en proporción a ella: con 1769 MB tienes el equivalente a un procesador virtual (vCPU) entero, y con 128 MB, catorce veces menos. He ejecutado el mismo trabajo, 300 000 hashes SHA-256 encadenados en Python puro, con distintas memorias (cpu/lambda_function.py):
| Memoria | Tiempo (mediana de 5) | GB-segundos por llamada | Coste por millón de llamadas (dólares) |
|---|---|---|---|
| 128 MB | 3,11 s | 0,39 | 6,73 |
| 256 MB | 1,53 s | 0,39 | 6,65 |
| 512 MB | 0,78 s | 0,40 | 6,86 |
| 1024 MB | 0,41 s | 0,42 | 7,15 |
| 1769 MB | 0,23 s | 0,41 | 6,97 |
| 3008 MB | 0,23 s | 0,69 | 11,66 |
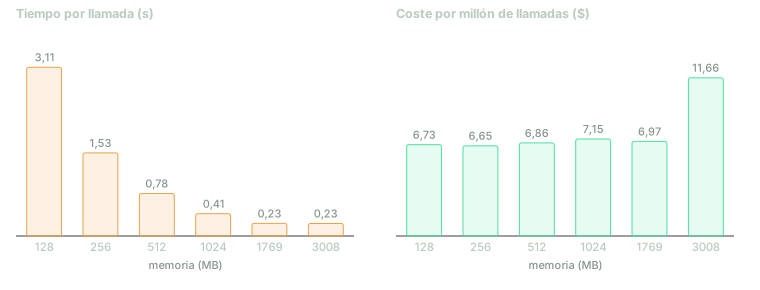
Hasta 1769 MB, más memoria es más CPU y el mismo precio: la llamada dura menos en la misma proporción. A partir de ahí, un programa de un solo hilo no va más rápido y paga la diferencia.
Hasta 1769 MB, el tiempo baja en la misma proporción en que sube la memoria, así que el coste no
cambia: con 1769 MB la llamada es 13 veces más rápida y cuesta lo mismo. Por encima, Lambda da
más de un vCPU, pero mi programa es de un solo hilo y no puede usarlo, así que tarda lo mismo y paga
un 70 % más. Curiosamente, Python ve dos procesadores con cualquier memoria (os.cpu_count()
devuelve 2): Lambda no quita procesadores, limita el tiempo que puede usarlos. Como referencia, un
solo núcleo del Core i5-6300U de mi portátil hace el mismo trabajo en 0,29 s; con 128 MB, Lambda
tarda once veces más. Lo que hay debajo, según /proc/cpuinfo, es un Xeon de Intel a 2,5 GHz,
sin más detalle.
Y un detalle de cuenta nueva: no me dejó pasar de 3008 MB, aunque el máximo de Lambda es 10 240.
Lo que se cobra es tiempo de reloj, no de CPU. La función del principio, dormida cinco segundos con
espera=5, facturó 5 003 ms sin usar el procesador. Para una función que espera la respuesta de una
base de datos o de un modelo de lenguaje, que puede tardar veinte segundos, se paga cada segundo de
espera.
Lo que cambia en tu código
Una máquina que no recuerda
La variable llamadas del principio funciona como un contador mientras la instancia vive, y por eso
la segunda petición vio un 2. Pero con diez instancias hay diez contadores, cada uno con su cuenta, y
a los pocos minutos sin tráfico desaparecen todos. Lo mismo pasa con el directorio /tmp, el único
en el que una función puede escribir: sobrevive entre peticiones de la misma instancia, y con ella
muere.
Así que lo que tiene que durar (un pedido, una sesión, un contador de verdad) va fuera de la función,
a una base de datos, una caché externa o un almacén de ficheros como S3. Las variables globales y
/tmp sirven como caché, para no repetir trabajo, nunca como el único sitio donde está un dato.
Lo que queda por hacer después de responder
En un servidor es normal contestar enseguida y terminar el trabajo después, en otro hilo: mandar un correo, escribir una estadística. En Lambda no funciona, porque al responder la instancia se congela con el hilo a medio hacer. Esta función (congela/lambda_function.py) lanza un hilo que apunta la hora cada 0,1 s, durante dos segundos, y responde sin esperarlo:
def tarea():
    for _ in range(20):
        time.sleep(0.1)
        marcas.append(time.time())
La llamo, espero diez segundos y le pregunto por las marcas. La primera debería haberse apuntado 0,1 s después de lanzar la tarea. Se apuntó 10,3 s después, en las tres repeticiones: el hilo pasó los diez segundos congelado, y siguió justo cuando la segunda petición descongeló la instancia. Si no hubiera llegado otra petición, no habría terminado nunca. La regla es simple: lo que no esté hecho cuando respondes puede no hacerse. O se termina antes de responder, o se deja en una cola para que lo haga otra función.
Al menos una vez
He invocado de forma asíncrona una función que siempre falla (falla/lambda_function.py). Lambda la ejecutó tres veces con el mismo identificador de petición: la segunda, 62 s después de la primera, y la tercera, 106 s después de la segunda (en otra repetición, 66 y 119 s). Es lo que dice la documentación: dos reintentos, a uno y dos minutos. Y añade algo más incómodo: aunque la función no falle, puede recibir el mismo evento más de una vez, porque la cola interna de Lambda no garantiza lo contrario.
Así que una función que reacciona a eventos tiene que ser idempotente: ejecutarla dos veces con el mismo evento tiene que dejar las cosas igual que ejecutarla una. Si la función cobra un pedido, el segundo intento no puede cobrarlo otra vez. Lo habitual es guardar en la base de datos el identificador de cada evento ya procesado, con una restricción que impida guardarlo dos veces, y comprobarlo antes de actuar.
La base de datos no escala igual
Una aplicación en un servidor abre unas cuantas conexiones con su base de datos y las reparte entre todas sus peticiones (un pool de conexiones). En Lambda, cada instancia es un proceso aparte y abre las suyas. Con mil instancias a la vez, mil conexiones, y PostgreSQL acepta por defecto cien. El escalado que tanto ayuda a la función tumba la base de datos.
Hay tres salidas. Un intermediario que reparte pocas conexiones reales entre muchas instancias, como RDS Proxy o PgBouncer. Bases de datos que se hablan por HTTP y no por una conexión persistente, como DynamoDB. O limitar cuántas instancias puede tener la función, a costa de rechazar peticiones en los picos.
Límites
Una invocación dura como mucho quince minutos. Una petición síncrona y su respuesta no pueden pasar
de 6 MB cada una. El Init tiene diez segundos para terminar. Una función no puede recibir
conexiones, sólo eventos, así que no puede mantener abierto un WebSocket (una conexión que el
servidor usa para enviar datos al navegador cuando quiera) ni hacer de servidor de un juego. Depurar
es más difícil, porque no hay una máquina a la que entrar: hay registros repartidos por instancias.
Y el código se mueve bien a otro proveedor, pero lo que lo rodea, los disparadores, los permisos, las
colas, no: eso es lo que te ata a la plataforma.
Cuánto cuesta, y dónde se cruzan las curvas
Con los precios de Irlanda he comparado Lambda con el servidor más pequeño que tiene sentido
comparar: un c7g.medium de EC2, con un vCPU de
un procesador Graviton3 y 2 GB, sin créditos que se agoten. Encendido todo el mes cuesta 28,32 dólares. Pero
un servidor solo se cae con él, así que en producción lo razonable son dos y un balanceador de carga
que reparta las peticiones: 80,88 dólares al mes. Las cuentas, sin
contar la capa gratuita:
| Tipo de petición | Coste por millón en Lambda (dólares) | Cuesta lo mismo que un servidor a… | … que dos y un balanceador a… |
|---|---|---|---|
| Ligera (20 ms, 128 MB) | 0,24 | 45 peticiones/s | 127 peticiones/s |
| Típica (100 ms, 512 MB) | 1,03 | 10 peticiones/s | 30 peticiones/s |
| Pesada (1 s, 1769 MB) | 28,99 | 0,4 peticiones/s | 1,1 peticiones/s |
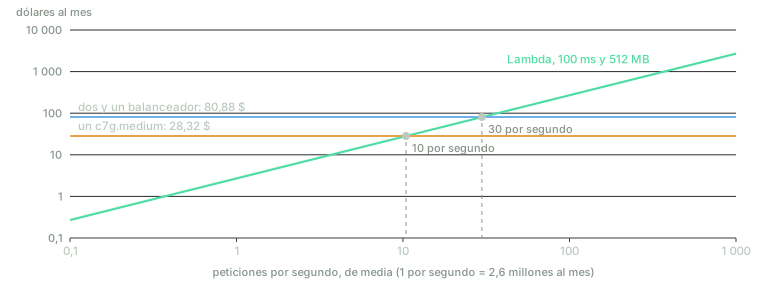
Por debajo del cruce, Lambda; por encima, el servidor. Con tráfico bajo o con picos, el servidor pierde por mucho; con tráfico alto y constante, gana por mucho.
La cifra que lo resume es otra: un vCPU ocupado una hora cuesta 0,104 dólares en Lambda y 0,039 en el
c7g.medium, 2,7 veces menos. Para trabajo que usa la CPU, Lambda compensa mientras el servidor
estaría ocupado menos del 37 % del tiempo (con dos servidores y un balanceador, bastante más). Para trabajo que espera, es peor que eso:
el servidor atiende cientos de peticiones que esperan con un solo vCPU, y Lambda cobra cada espera
en una instancia distinta.
La factura de Lambda no es sólo Lambda. API Gateway cuesta 3,50 dólares por millón de peticiones en su versión completa (1,11 en la sencilla), más que la propia función en el caso ligero; las Function URLs son gratis, pero hacen menos. Los registros cuestan 0,57 dólares por GB, y una función que escribe mucho en ellos puede pagar más por eso que por ejecutarse. Y al revés, la factura del servidor tampoco es sólo el servidor: alguien lo actualiza, lo vigila y se levanta cuando se cae, y esas horas no salen en la tabla.
El caso más citado contra serverless es el de Prime Video. En 2023 contaron que su sistema para vigilar la calidad de las retransmisiones, construido con Step Functions (el orquestador de funciones de AWS), Lambda y S3, sólo aguantaba el 5 % de la carga prevista y costaba demasiado: hacía varias transiciones del orquestador por cada segundo de vídeo, y pasaba los fotogramas entre funciones a través de S3. Lo juntaron todo en un único proceso en contenedores, y el coste bajó un 90 %. No es una prueba de que serverless no sirva. Es el caso exacto en que no sirve: trabajo constante, intenso, y muchos pasos que se pasan muchos datos.
Lo que vino después de Lambda
Casi todo lo que AWS ha añadido desde 2014 ha sido para quitar límites o para esconder el arranque en
frío. En 2018, las funciones pasaron de cinco a quince minutos. En 2019 llegó la concurrencia
aprovisionada: pagar por tener un número de instancias siempre preparadas, es decir, volver a pagar
por capacidad ociosa a cambio de no tener arranques en frío. En 2020, la facturación pasó de tramos
de 100 ms a milisegundos, y las funciones pudieron empaquetarse como contenedores de hasta 10 GB. En
2024, SnapStart llegó a Python: Lambda
ejecuta el Init una vez, guarda una instantánea de la memoria de la máquina virtual ya preparada, y
arranca las instancias nuevas desde la instantánea.
Mientras, la idea salió de las funciones. Google lanzó en 2019 Cloud Run, que lleva el modelo a contenedores enteros que atienden muchas peticiones a la vez cada uno. Las bases de datos aprendieron a cobrar por uso y a bajar a cero.
Y en el último año, la propia Lambda ha ido recuperando cosas de los servidores. Lambda Managed Instances (noviembre de 2025) ejecuta funciones en máquinas de EC2 que eliges tú, cada una atendiendo varias peticiones a la vez, y se paga como EC2 más un recargo del 15 %. Las durable functions (diciembre de 2025) guardan el progreso de una función para que pueda esperar hasta un año sin cobrar. Y el 12 de octubre de 2026, AWS presentó Lambda Web Functions: tu código es un servidor HTTP normal, que escucha en un puerto, cada instancia atiende 64 peticiones a la vez por defecto (hasta 128), y se cobra el tiempo de CPU activo, no el de espera. Fue entonces cuando AWS rebautizó las funciones clásicas como Event Functions.
Los dos rasgos que definían Lambda en 2014, una petición por instancia y cobrar el tiempo de reloj, son hoy opciones. Lo que queda de serverless, en todas sus formas, es lo de la definición: no eliges máquinas, pagas por uso y bajas a cero. Serverless está dejando de ser una forma de programar para convertirse en una forma de operar y de cobrar.
Cuándo elegir cada uno
| Si tu carga… | Mejor | Por qué |
|---|---|---|
| tiene picos, o pasa horas sin tráfico | Serverless | Bajas a cero y no pagas la espera |
| reacciona a eventos: un fichero subido, un mensaje, un aviso de otro servicio, una tarea programada | Serverless | Es para lo que se diseñó |
| es una herramienta interna, un prototipo o un proyecto con poco tráfico | Serverless | Con la capa gratuita, a menudo cuesta cero |
| la lleva un equipo pequeño sin nadie que opere máquinas | Serverless | No hay sistema operativo que parchear |
| es alta y constante | Servidor o contenedores | El vCPU-hora cuesta casi tres veces menos |
| pasa la mayor parte del tiempo esperando a otros servicios | Servidor, o una plataforma que cobre la CPU activa | Event Functions cobra la espera |
| necesita una latencia baja en cada petición, sin excepciones | Servidor, o concurrencia aprovisionada | Los arranques en frío |
| mantiene conexiones abiertas o mucho estado en memoria | Servidor | Las instancias no reciben conexiones y mueren solas |
| dura más de quince minutos | Servidor, colas con trabajadores, o funciones duraderas | El límite de la invocación |
La mayoría de los sistemas reales mezclan los dos: un servidor o unos contenedores para el tráfico principal, y funciones para lo que llega de vez en cuando, como redimensionar las imágenes que suben los usuarios o enviar el resumen semanal.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: serverless no elimina los servidores, elimina tu decisión sobre ellos. Pagas sólo lo que usas, a cambio de que cada instancia pueda nacer en mitad de una petición y desaparecer a los pocos minutos de quedarse sin trabajo. Todo lo que hay que saber para usarlo bien sale de esas dos mitades.
Y si te llevas tres cosas más, que sean prácticas.
Mide lo que haces al arrancar. Cada import del principio del fichero se paga en cada instancia
nueva: 0,25 s por boto3, casi 3 s por pandas. Importa sólo lo que usas, y si empaquetas bibliotecas
grandes en Python, compila sus .pyc por hash.
Escribe cada función como si fuera a ejecutarse dos veces y a olvidarlo todo. Puede pasar las
dos cosas. Nada importante en memoria ni en /tmp, nada a medias después de responder, y cada evento
comprobado antes de actuar.
Haz la cuenta con la ocupación, no con las peticiones. Si un vCPU tuyo estaría ocupado más de un tercio del tiempo, o si tus funciones pasan la mayor parte del tiempo esperando, un servidor sale más barato. Por debajo, Lambda gana por mucho.
Hace treinta años, CGI arrancaba un proceso por petición y FastCGI lo mantenía vivo para no pagar el arranque. Lambda vuelve a hacer la misma cuenta, ahora con máquinas virtuales, y la deja en manos del proveedor. Sigue habiendo servidores; lo que ya no hay es nadie en tu equipo que tenga que decidir cuántos.