 Por Gustavo Torres
El 11 de octubre de 1999, NVIDIA, un fabricante de tarjetas gráficas, puso a la venta la GeForce 256 y la anunció como «la primera GPU del mundo». Una GPU (graphics processing unit, unidad de procesamiento gráfico) era, según la definición que la propia NVIDIA escribió para la ocasión, un chip que dibuja escenas en 3D sin ayuda. Lo nuevo de la GeForce 256 era que se encargaba ella misma de un cálculo que hasta entonces hacía el procesador del ordenador: multiplicar cada vértice de la escena por una matriz de 4×4 para colocarlo delante de la cámara.
Veinticinco años después, Meta, la empresa de Facebook, entrenó Llama 3, un modelo de lenguaje de 405 000 millones de parámetros, en 16 384 GPU H100 de NVIDIA. Las H100 descienden en línea directa de aquella tarjeta, pero ya casi no saben dibujar: no tienen salida de vídeo, y de sus 132 bloques de cálculo sólo 4 pueden ejecutar los programas con los que un videojuego pinta la pantalla.
¿Cómo acaba un chip de videojuegos entrenando modelos de lenguaje? ¿Por qué no se hace con el procesador, que está en todos los ordenadores? Y si la inteligencia artificial (IA) mueve tanto dinero, ¿por qué no se ha inventado un chip sólo para ella?
Un videojuego y un modelo de lenguaje hacen, en el fondo, el mismo trabajo: multiplicar matrices, millones de veces, con un límite de tiempo. El procesador está diseñado para un trabajo casi opuesto, y por eso los videojuegos tuvieron que inventarse un chip propio. Los modelos de lenguaje heredaron ese chip y, como hicieron antes los videojuegos, ya están construyendo el suyo.
La historia se cuenta dos veces, primero con los videojuegos y después con los modelos de lenguaje, y las dos siguen los mismos pasos: qué se calcula, por qué tiene que ser rápido, por qué el procesador no basta y qué chip se construyó para ello. Antes, tres propiedades de la operación que une las dos historias, la multiplicación de matrices. Todas las cifras vienen de especificaciones publicadas por los fabricantes o de los artículos que se enlazan, y las que se obtienen combinándolas explican al lado cómo.
La operación de la que va todo esto
Multiplicar una matriz de por otra de cuesta unas operaciones, la mitad multiplicaciones y la mitad sumas. Son operaciones de coma flotante, el formato en que el ordenador guarda los números con decimales, y por eso la potencia de un chip se mide en FLOPS (floating-point operations per second), operaciones de coma flotante por segundo. Un TFLOPS es un billón () de operaciones por segundo, y un PFLOPS, mil billones.
Tres propiedades de esta operación explican casi todo lo que sigue.
Cada número del resultado es independiente de los demás. Cada producto escalar se puede calcular a la vez que los otros, en otro sitio y en el orden que se quiera.
No hay decisiones. La receta es siempre la misma, multiplicar y sumar, y no hay ningún «si pasa esto, haz lo otro» que dependa de los datos.
Cada número se usa muchas veces. En el producto de dos matrices de , cada número de la primera se multiplica por números de la segunda. Son operaciones sobre números de entrada, operaciones por número: con matrices de mil por mil, cada número leído de memoria puede alimentar mil operaciones, siempre que se consiga tenerlo a mano mientras tanto.
Las tres valen igual para un videojuego que para un modelo de lenguaje. Lo que cambia es el tamaño de las matrices.
Los videojuegos
Qué calcula un videojuego
Un mundo en 3D es, para el ordenador, una colección de triángulos. Un personaje, una pared o un árbol son mallas de miles de triángulos, y cada triángulo queda definido por sus tres vértices, cada uno con tres coordenadas: , y . Para dibujar un fotograma, cada una de las imágenes fijas que, una detrás de otra, forman la animación, el juego hace dos grandes trabajos.
Primero, colocar cada vértice. Las coordenadas de un personaje se guardan respecto a su propio centro. Para pintarlo hay que llevarlo a su sitio en el mundo, girarlo, verlo desde donde está la cámara y proyectarlo sobre la pantalla, que es plana. Cada uno de esos pasos es una multiplicación por una matriz, y como multiplicar por varias matrices seguidas es lo mismo que multiplicar por su producto, el juego las combina en una sola y la aplica a todos los vértices del objeto:
La matriz es de 4×4, y no de 3×3, por un truco. Con un cuarto número añadido al vértice, siempre un 1, también desplazar un objeto se convierte en una multiplicación: la cuarta columna de la matriz suma una cantidad fija a cada coordenada. Y la perspectiva, que hace que lo lejano se vea más pequeño, también: la cuarta coordenada del resultado, , crece con la distancia, y al dividir e entre ella lo lejano encoge. Son 16 multiplicaciones y 12 sumas por vértice, con la misma matriz para todos los vértices del objeto.
Después, pintar cada píxel. Una vez proyectado, cada triángulo cubre unos cuantos píxeles, los puntos de color que forman la imagen, y averiguar cuáles cubre se llama rasterizar. Después hay que decidir el color de cada uno, y eso también es álgebra. El brillo de una superficie mate, por ejemplo, depende del ángulo entre la dirección hacia la que mira (su normal, un vector perpendicular a ella) y la dirección de la que llega la luz, y ese ángulo sale de un producto escalar. Encima van las texturas (imágenes pegadas sobre los triángulos), las sombras y los reflejos, pero el patrón no cambia: el mismo cálculo, con datos distintos, para cada píxel.
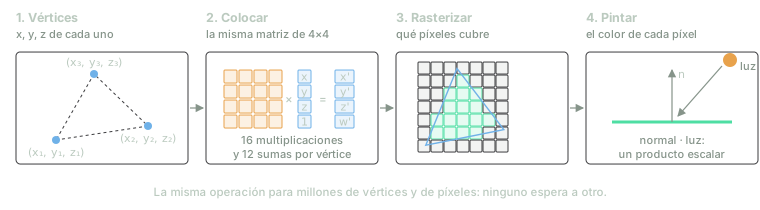
Un fotograma, simplificado. Los dos bucles grandes, uno por vértice y otro por píxel, repiten la misma álgebra pequeña con datos que no dependen unos de otros.
Los dos trabajos tienen la forma de la multiplicación de matrices: un cálculo pequeño, siempre el mismo, repetido sobre millones de elementos que no dependen unos de otros. El color de un píxel no espera al del vecino.
Por qué tiene que ser rápido
Un juego no dibuja una imagen: dibuja sesenta por segundo, o más. A 60 fotogramas por segundo, cada uno tiene 16,7 milisegundos para estar listo, y si llega tarde el jugador ve un tirón. Una pantalla Full HD (1920 × 1080) tiene 2 073 600 píxeles, y una 4K (3840 × 2160), 8 294 400. A 4K y 60 fotogramas por segundo son casi 500 millones de píxeles por segundo, cada uno con su cálculo de color, sin contar los que se pintan y luego quedan tapados por algo más cercano.
Y no se puede adelantar trabajo, porque nadie sabe qué habrá en el siguiente fotograma hasta que el jugador mueve la cámara. El cine de animación sí puede esperar: a Pixar, cada fotograma de Toy Story (1995) le costó entre 45 minutos y 30 horas de cálculo, en un grupo de 117 estaciones de trabajo de Sun. Un juego tiene que hacer algo parecido en 16 milisegundos, y repetirlo sin parar.
Fíjate en qué es lo que tiene límite de tiempo. Ningún píxel tiene prisa por sí solo: el límite es para el fotograma entero, y da igual que un píxel tarde mucho si los dos millones terminan a tiempo. Lo que un juego necesita es rendimiento (throughput), cuánto trabajo se termina por segundo, y no latencia, cuánto tarda cada tarea por separado. Esa distinción decide qué chip sirve.
Por qué la CPU no daba abasto
La CPU (central processing unit, unidad central de procesamiento) es el procesador de propósito general del ordenador: ejecuta el sistema operativo, el navegador y la lógica del juego. Está diseñada para ejecutar un hilo de instrucciones, una secuencia en la que cada paso suele depender del anterior, lo más deprisa posible, y para eso dedica buena parte del chip a no tener que esperar.
Cachés. Leer un dato de la memoria principal tarda del orden de cien nanosegundos, tiempo en el que un núcleo podría haber hecho cientos de operaciones. Las cachés son memorias pequeñas y rápidas, dentro del chip, que guardan los datos usados hace poco por si vuelven a hacer falta.
Predicción de saltos. Un programa normal está lleno de decisiones: si el jugador pulsa el botón, el personaje salta. La CPU apuesta por el camino que tomará cada decisión y sigue trabajando antes de saberlo. Si se equivoca, deshace lo hecho.
Ejecución fuera de orden. Si una instrucción espera un dato, la CPU busca más adelante otras que no dependan de él y las adelanta.
Todo eso hace rápido un programa con muchas decisiones y datos imprevisibles, que es casi todo el software. Y nada de eso ayuda a pintar píxeles: no hay decisiones que adivinar, se sabe de antemano qué datos hacen falta, y hay millones de cálculos independientes esperando turno. Un núcleo es la parte de la CPU que ejecuta un hilo, y la CPU de 1996 tenía uno solo, que gastaba la mayor parte de su superficie en hacer rápido ese hilo, no en sumar y multiplicar.
Los juegos sí se dibujaron con la CPU, durante años. Quake, el juego de disparos de id Software de junio de 1996, lo hacía todo con ella. En la caja pedía un Pentium, el procesador de Intel de la época, a 75 MHz como mínimo, y un Pentium a 120 MHz se movía en torno a los 30 fotogramas por segundo. Cada fotograma de más, o cada píxel de más, había que pagarlo con un procesador más caro.
Intel respondió en 1997 con MMX, su primer juego de instrucciones SIMD (single instruction, multiple data, una instrucción, varios datos), pensado para multimedia y juegos: una sola instrucción opera sobre varios números a la vez, por ejemplo cuatro sumas de golpe. En 1999 llegó SSE (Streaming SIMD Extensions), que hacía lo mismo con números con decimales, cuatro a la vez. Ayudaba, pero un núcleo con SIMD seguía haciendo un puñado de operaciones por ciclo de reloj, y los píxeles eran millones. Y la CPU tenía otras cosas que hacer: la física, el sonido, el comportamiento de los enemigos.
Hacía falta un chip con la apuesta contraria: renunciar a que cada tarea por separado sea rápida a cambio de hacer muchísimas a la vez.
Un chip propio: la GPU
La primera respuesta fueron las tarjetas aceleradoras 3D, placas que se añadían al ordenador sólo para dibujar. La Voodoo Graphics, de la empresa 3dfx, llegó a finales de 1996 y hacía la mitad del trabajo: rasterizaba los triángulos y les pegaba las texturas, pero la CPU seguía colocando los vértices. En enero de 1997, id Software publicó GLQuake, una versión de Quake que dibujaba con estas tarjetas, y la diferencia se veía a simple vista: más resolución y texturas suavizadas.
La GeForce 256, en 1999, se llevó también la otra mitad. La definición de NVIDIA hablaba de «un procesador en un solo chip con motores integrados de transformación, iluminación, preparación y recorte de triángulos y dibujo, capaz de procesar al menos 10 millones de polígonos por segundo». La transformación es la multiplicación por la matriz de 4×4: en 1999, la operación de la que va este artículo salió de la CPU y pasó a un chip propio.
Aquellos chips eran de función fija: cada etapa hacía una cosa, la que habían decidido sus diseñadores. En 2001, la GeForce 3 trajo los shaders programables, pequeños programas que escribe el propio juego y que la GPU ejecuta una vez por cada vértice o por cada píxel. Desde entonces, la GPU ejecuta cualquier cálculo que se le pida, con una condición: que sea el mismo para millones de elementos. En 2006, la GeForce 8800 unificó los dos tipos de shader en un solo tipo de núcleo, y tenía 128, que servían tanto para vértices como para píxeles.
De ahí sale el diseño que siguen teniendo las GPU, y que es el contrario del de una CPU.
Muchos núcleos sencillos. Una CPU de sobremesa tiene una o dos docenas de núcleos grandes, y las de servidor más grandes, unos pocos cientos. La GeForce RTX 5090, la tarjeta de juegos más potente de NVIDIA, de 2025, tiene 21 760 núcleos pequeños, que en total hacen 104,8 TFLOPS. A 4K y 60 fotogramas por segundo, eso da unas 210 000 operaciones por píxel y por fotograma.
Una instrucción para muchos hilos. Los núcleos se agrupan en multiprocesadores (los bloques de cálculo de los que hablaba el principio), y en las GPU de NVIDIA cada grupo de 32 hilos, un warp, ejecuta la misma instrucción a la vez, cada hilo con sus propios datos. NVIDIA lo llama SIMT (single instruction, multiple threads, una instrucción, varios hilos). Leer una instrucción y decidir qué hacer con ella cuesta lo mismo para un hilo que para 32, así que casi todo el chip puede dedicarse a calcular.
Esperar sin pararse. Una GPU no intenta evitar las esperas a la memoria con cachés enormes y predicciones. Tiene miles de hilos en marcha, y cuando un warp espera un dato, el planificador pasa a otro que ya tiene el suyo, sin coste. Funciona porque los gráficos siempre tienen millones de hilos disponibles.
Una memoria muy ancha. La RTX 5090 lee 1 792 GB por segundo de su memoria. Un ordenador de sobremesa con dos módulos de DDR5-5600, el tipo de memoria habitual hoy en un ordenador, lee como mucho 89,6.
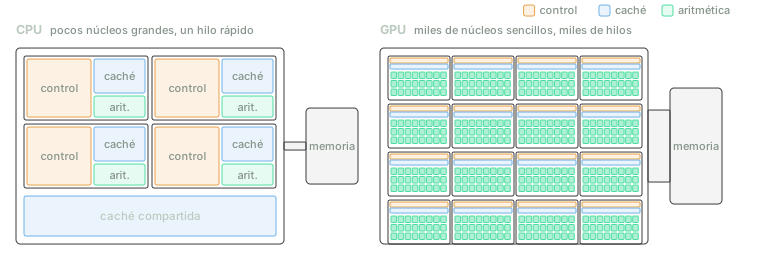
Esquema, no a escala. La CPU gasta el chip en que un hilo no espere; la GPU, en tener aritmética para miles de hilos y una memoria que la alimente.
El precio es que una GPU es mala en lo que la CPU hace bien. Un hilo solo avanza despacio, y si los hilos de un warp toman caminos distintos en una decisión, el warp ejecuta los dos caminos uno detrás de otro. Por eso un ordenador tiene las dos: la CPU para el programa, la GPU para los millones de cálculos iguales.
De dibujar a calcular
En cuanto los shaders fueron programables, a algunos investigadores se les ocurrió que una GPU era, en el fondo, una máquina de hacer la misma operación sobre millones de números, más rápida que cualquier CPU. Sólo había que disfrazar el problema de dibujo. En 2001, E. Scott Larsen y David McAllister, de la Universidad de Carolina del Norte, publicaron Fast matrix multiplies using graphics hardware: guardaban las matrices como texturas y dejaban que la etapa que combina texturas hiciera las multiplicaciones y las sumas. El resultado, como dice su resumen, se obtenía visualizando literalmente el cálculo.
Funcionaba, pero obligaba a plantear cada cálculo como si fuera un dibujo. En 2007, NVIDIA publicó CUDA (Compute Unified Device Architecture), una forma de programar sus GPU en una variante del lenguaje C, sin texturas ni píxeles: el programador escribe una función y pide que se ejecute en un millón de hilos a la vez. La primera GPU que lo admitía era la GeForce 8800, una tarjeta para jugar.
Las redes neuronales fueron de las primeras en aprovecharlo, porque por dentro son sobre todo multiplicaciones de matrices. En 2009, Rajat Raina, Anand Madhavan y Andrew Ng, en Stanford, entrenaron redes en GPU hasta 70 veces más deprisa que en un procesador de dos núcleos: un modelo de 100 millones de parámetros pasaba de varias semanas de entrenamiento a un día. Y en 2012, AlexNet, la red de Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton, ganó con mucha ventaja ImageNet, un concurso de reconocimiento de imágenes. La entrenaron durante cinco o seis días en dos GeForce GTX 580, tarjetas de juegos con 3 GB de memoria cada una, y tuvieron que repartir la red entre las dos porque no cabía en una. Ahí arrancó el aprendizaje profundo moderno, el de las redes con muchas capas, y arrancó con hardware de tienda de videojuegos.
Los modelos de lenguaje
Qué calcula un modelo de lenguaje
Un modelo de lenguaje es una red neuronal que, dado un texto, calcula qué es probable que venga después. Un LLM (large language model, modelo de lenguaje grande) es uno con miles de millones de parámetros, entrenado con una parte enorme del texto público de Internet. El texto entra partido en tokens, trozos de palabra (una palabra corta suele ser un token; una larga, varios), y la respuesta sale de token en token: el modelo calcula el siguiente, lo añade al texto y vuelve a empezar.
Dentro del modelo, cada token es un vector: en Llama 3 405B, el modelo del principio, uno de 16 384 números. Casi todo lo que el modelo hace con esos vectores es multiplicarlos por matrices. Casi todos los LLM actuales son transformers, la arquitectura que se publicó en 2017, y un transformer es una pila de capas iguales, 126 en Llama 3 405B, cada una con dos partes.
La atención deja que cada token mire a los anteriores. El vector de cada token se multiplica por tres matrices para obtener otros tres: una consulta (qué busca), una clave (qué ofrece) y un valor (qué aporta si lo eligen). Comparar la consulta de cada token con las claves de todos los anteriores es otra multiplicación de matrices; mezclar sus valores según esa comparación, otra más, y una cuarta matriz devuelve el resultado a 16 384 números. En Llama 3 las matrices de la clave y del valor son más estrechas, de 1 024 columnas, por una optimización que ahorra memoria.
La red feed-forward procesa cada token por separado: multiplica su vector por una matriz que lo ensancha de 16 384 a 53 248 números, aplica a cada número una función sencilla y lo multiplica por otra matriz que lo devuelve a 16 384. Llama 3 usa una variante con tres matrices en lugar de dos.
Al final de la pila, una última matriz convierte el vector en una puntuación para cada uno de los 128 000 tokens del vocabulario, y de ahí sale el siguiente token.
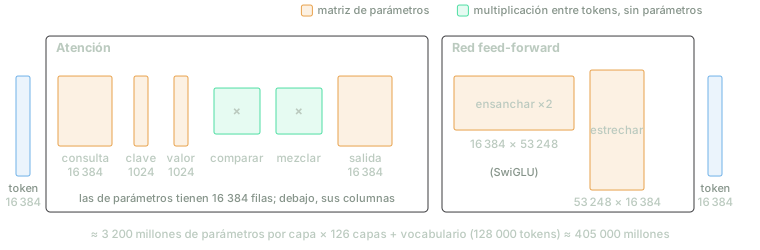
Una capa de Llama 3 405B. Lo que no es multiplicar matrices (normalizar, convertir las comparaciones en pesos, la función sencilla) son pocas operaciones por número.
Las matrices son los parámetros. Las de una capa de Llama 3 405B suman unos 3 200 millones de números, y las 126 capas, más las del vocabulario, dan los 405 000 millones del nombre. Cada parámetro interviene en una multiplicación y una suma por cada token que pasa por el modelo, así que procesar un token cuesta unas operaciones, donde es el número de parámetros: unos 810 000 millones en Llama 3 405B.
Entrenar cuesta el triple por token. Al entrenar, el modelo lee un texto, predice cada token a partir de los anteriores, mide cuánto se ha equivocado y ajusta los parámetros para equivocarse menos. A la pasada hacia delante, que hace la predicción, se suma una pasada hacia atrás, que calcula en qué dirección mover cada parámetro y cuesta el doble que la primera. En total, unas operaciones por token. Llama 3 405B se entrenó con 15,6 billones de tokens:
Un 38 seguido de 24 ceros, la misma cifra que publica Meta.
Es la misma operación que en un videojuego, con dos diferencias de escala. Las matrices no son de 4×4, sino de miles por miles. Y no se multiplican por un vector cada vez, sino por muchos: al entrenar Llama 3, cada paso procesaba 16 millones de tokens a la vez, de modo que los vectores de los tokens se apilan en una matriz y cada multiplicación es de matriz por matriz.
Por qué tiene que ser rápido
Meta entrenó Llama 3 405B en 16 384 GPU H100, y cada una sostuvo unos 400 TFLOPS, el 41 % del máximo teórico. A ese ritmo, una sola H100 habría tardado unos 3 000 años en hacer las operaciones. Las 16 384 juntas, unos 67 días.
Con tantas piezas, algo se rompe siempre. Meta cuenta que en un periodo de 54 días del entrenamiento hubo 466 interrupciones, 419 de ellas imprevistas, y que más de la mitad de las imprevistas fueron fallos de las propias GPU: una interrupción cada tres horas, de media. Cada una obliga a volver al último punto guardado.
Y un modelo se entrena una vez, pero se usa millones. A usarlo se le llama inferencia: el modelo ya entrenado, generando respuestas. Cada token generado cuesta operaciones, y también tiene un límite de tiempo, como el fotograma: un chat que escribe a 20 tokens por segundo tiene 50 milisegundos para cada token. Y no lo hace para una persona, sino para todas las que lo usan a la vez.
El paralelismo con los videojuegos es exacto: el mismo cálculo sobre millones de datos, con un límite de tiempo que vuelve cada pocos milisegundos.
Por qué la GPU encaja, y la CPU no
Las tres propiedades del principio explican por qué encaja la GPU.
Los resultados son independientes, como los píxeles, así que miles de núcleos pueden calcular cada uno su trozo a la vez.
No hay decisiones, también como en los píxeles, así que la predicción de saltos y la ejecución fuera de orden de una CPU no tienen nada que adivinar ni que reordenar.
Cada número se reutiliza muchas veces. Al multiplicar una matriz de 16 384 × 16 384 por otra igual, cada número leído de memoria alimenta 16 384 operaciones. Si el chip consigue tener los números cerca de la aritmética mientras los usa, la velocidad la marca cuánto calcula, no cuánto lee. Esa propiedad tiene nombre: la intensidad aritmética de un cálculo es cuántas operaciones hace por cada byte que lee de memoria. Volverá a salir enseguida.
¿Y la CPU? La de hoy no es la de 1996. Igual que Intel añadió MMX para los juegos, desde 2023 sus procesadores de servidor Xeon traen AMX (Advanced Matrix Extensions), una unidad de multiplicar matrices dentro de cada núcleo. Intel le atribuye un máximo de 1 024 operaciones por ciclo y por núcleo con números de 16 bits. El Xeon 6980P, de 2024, tiene 128 núcleos a 2 GHz, así que en el papel llega a unos 262 TFLOPS.
Para compararlo con las GPU hace falta una cosa más: la precisión. BF16 es un formato de 16 bits para números con decimales, la mitad que el habitual de 32; FP8 y FP4 usan 8 y 4 bits, e INT8, enteros de 8 bits, cuya velocidad se mide en TOPS, billones de operaciones con enteros por segundo. Cuantos menos bits, menos precisión, pero más operaciones por segundo y menos bytes que mover. Las redes neuronales toleran bien esa pérdida, y por eso los chips para IA compiten en estas precisiones. Frente a las GPU para centros de datos de NVIDIA, la H100 y la B200:
| Xeon 6980P (CPU, 2024) | H100 (GPU, 2022) | B200 (GPU, 2024) | |
|---|---|---|---|
| Matrices en BF16 | ≈ 262 TFLOPS | 989 TFLOPS | 2 250 TFLOPS |
| En su precisión más baja | INT8: ≈ 524 TOPS | FP8: 1 979 TFLOPS | FP4: 9 000 TFLOPS |
| Ancho de banda de memoria | 845 GB/s | 3 350 GB/s | 8 000 GB/s |
| Memoria | hasta 3 TB | 80 GB | 180 GB |
| Consumo | 500 W | 700 W | ≈ 1 000 W |
Las cifras de los tres son máximos teóricos que en la práctica no se alcanzan, pero sirven para comparar.
La tabla dice tres cosas. La primera, que la distancia ya no es de cien a uno. En 2009, Raina y sus coautores medían hasta 70 veces entre una GPU y una CPU de dos núcleos; hoy, en el papel, una H100 multiplica matrices en BF16 unas cuatro veces más deprisa que un Xeon de 128 núcleos, y una B200, unas nueve. En la precisión más baja de cada uno, la distancia vuelve a crecer: una B200 en FP4 hace 17 veces más operaciones que el Xeon en INT8.
La segunda, que la memoria está igual de lejos, entre cuatro y diez veces menos ancho de banda. Y por vatio, la H100 calcula casi tres veces más que el Xeon.
La tercera no sale en la tabla: cuántos se pueden juntar. Una placa de servidor lleva como mucho dos Xeon 6980P. Los servidores con los que Meta entrenó Llama 3 llevaban ocho GPU y dos CPU, y las ocho GPU se hablaban entre sí por NVLink, una conexión directa entre GPU de NVIDIA que en la H100 mueve 900 GB/s. Las CPU siguen ahí, pero para otra cosa: preparan los datos, coordinan y reparten el trabajo entre las GPU.
Hay una cuarta razón, menos técnica. El software de IA, desde las bibliotecas que multiplican matrices hasta PyTorch, la biblioteca de Python con la que se entrenan casi todos los modelos, lleva más de una década escribiéndose primero para las GPU de NVIDIA. Cuando la CPU añadió AMX, el resto del ecosistema ya estaba en otra parte.
Y en una cosa gana la CPU: la capacidad. Un Xeon admite hasta 3 TB de memoria, casi cuarenta veces la de una H100. Eso importa más de lo que parece, porque entrenar un modelo y usarlo no son el mismo problema.
Entrenar no es lo mismo que inferir
Entrenar pide tres cosas a la vez.
Cálculo. Con lotes de millones de tokens, cada multiplicación es de matriz por matriz y la intensidad aritmética es altísima: el chip pasa casi todo el tiempo calculando. Es el caso para el que se diseñan las GPU.
Memoria. Al entrenar no basta con guardar los parámetros. Hace falta también el gradiente de cada uno, en qué dirección moverlo, y el estado del optimizador, el algoritmo que decide cuánto moverlo; el más usado, Adam, guarda dos medias por parámetro. Con la receta habitual, que calcula en 16 bits pero guarda una copia de los parámetros en 32, son 16 bytes por parámetro: 6,5 TB para Llama 3 405B, lo que cabe en 81 H100, sólo para eso, sin contar los resultados intermedios de cada capa.
Red. Meta repartió el modelo de tres formas a la vez: cada matriz troceada entre las 8 GPU de un servidor, las capas repartidas en 16 grupos que se pasan el trabajo como en una cadena de montaje, y 128 copias de todo eso procesando datos distintos (). En cada paso, las GPU intercambian resultados, por NVLink dentro del servidor y por la red entre servidores. Un entrenamiento grande es tanto un problema de comunicaciones como de cálculo, y Meta escribe que su complejidad supera la de clústeres de CPU mucho más grandes que ya había operado.
La inferencia tiene dos fases, y se comportan de forma muy distinta.
El prefill lee la pregunta. Todos sus tokens se conocen desde el principio, así que el modelo los procesa juntos, matriz por matriz, igual que al entrenar, y va limitado por el cálculo.
La decodificación (decode) escribe la respuesta, y aquí todo cambia. Cada token nuevo depende del anterior, así que se generan de uno en uno, y cada uno tiene que pasar por todas las matrices del modelo. Es matriz por vector: cada parámetro se lee de memoria para una sola multiplicación y una suma. Con parámetros de 16 bits, son dos operaciones por cada dos bytes, una operación por byte.
Una H100 hace 989 billones de operaciones por segundo y lee 3,35 billones de bytes. Para tener ocupada su aritmética necesita unas 295 operaciones por cada byte que lee. La decodificación para una sola persona hace una, y aprovecha el 0,3 % del cálculo del chip. Lo que decide su velocidad es la memoria: Llama 3 8B, la versión pequeña, ocupa 16 GB en 16 bits, y una H100 sólo puede leerlos unas 200 veces por segundo, así que no generará más de unos 200 tokens por segundo para una persona, haga lo que haga. Llama 3 405B, con 810 GB en 16 bits, ni siquiera cabe en un servidor de ocho H100: Meta lo reparte entre las 16 GPU de dos servidores.
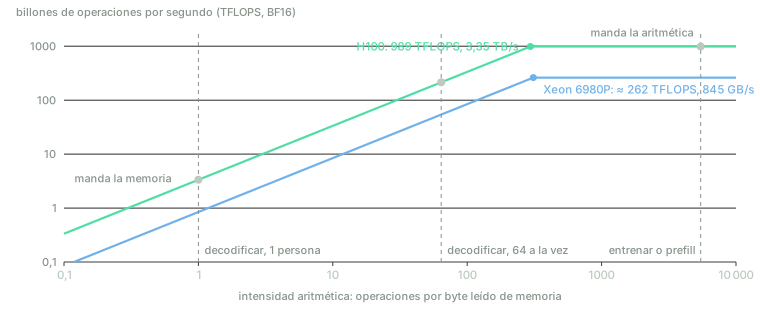
Con BF16 y especificaciones publicadas. A la izquierda del codo, la velocidad la pone la memoria; a la derecha, la aritmética. Decodificar para una persona queda muy a la izquierda.
Ese dibujo es el modelo roofline (de tejado, por su forma), y es la herramienta más útil para razonar sobre la velocidad de un chip: un cálculo a la izquierda del codo va limitado por la memoria, y uno a la derecha, por la aritmética. Las soluciones que usa todo el mundo para la decodificación consisten en moverse hacia la derecha o en leer menos.
Atender a muchos usuarios a la vez (batching). Si el servidor genera a la vez el siguiente token de 64 conversaciones, cada parámetro que lee sirve para 64 multiplicaciones, y la intensidad sube a 64. Hacen falta unas 300 para llenar una H100.
La caché KV. Para no recalcular en cada paso las claves y los valores de todos los tokens anteriores, se guardan en memoria (KV viene de key y value, clave y valor). Ahorra cálculo, pero ocupa memoria por cada conversación, y es lo que limita cuántas caben a la vez.
Cuantizar: guardar los parámetros en 8 o 4 bits en lugar de 16. Hay la mitad o la cuarta parte de bytes que leer, y la decodificación va casi el doble o el cuádruple de deprisa, a cambio de algo de precisión.
Y aquí vuelve la CPU. Como la decodificación depende de la memoria y no del cálculo, una máquina con memoria rápida la hace razonablemente bien. El Xeon 6980P, con sus 845 GB/s, puede leer Llama 3 8B en 16 bits unas 50 veces por segundo. Un portátil con dos módulos de DDR5-5600, con el modelo cuantizado a 4 bits (unos 4 GB), llega en el papel a unos 20 tokens por segundo. Por eso programas como llama.cpp, que ejecuta modelos de lenguaje en cualquier ordenador, funcionan en portátiles sin GPU. Entrenar uno así es otra historia.
Entrenar e inferir piden cosas distintas: el entrenamiento, cálculo, memoria para todo su estado y red entre miles de chips; la inferencia, sobre todo ancho de banda y que cada token cueste poco. Esa diferencia explica buena parte de lo que se ha construido después.
Un chip propio, otra vez
Los videojuegos tuvieron que inventarse un chip porque la CPU no les servía. Los modelos de lenguaje encontraron uno hecho, y desde entonces la historia se ha repetido dos veces: la GPU se ha ido convirtiendo en un chip para IA, y han aparecido chips diseñados sólo para ella.
La GPU se especializa. En 2017, la V100 de NVIDIA estrenó los núcleos tensoriales (Tensor Cores), unidades que no multiplican dos números, sino dos matrices pequeñas: cada uno calcula con matrices de 4×4, 64 multiplicaciones y sumas por ciclo. Los 640 de una V100 daban 125 TFLOPS, ocho veces lo que hacían los núcleos normales de la misma tarjeta. Es la tercera propiedad de la multiplicación de matrices llevada al circuito: si cada número se va a usar muchas veces, que el hardware lo reutilice sin volver a leerlo.
Detrás llegaron las precisiones bajas, FP8 en la H100 (2022) y FP4 en la B200 (2024), cada una con el doble de operaciones que la anterior; la memoria HBM (high bandwidth memory, memoria de gran ancho de banda), apilada junto al chip para leer más deprisa; y NVLink, para que muchas GPU se comporten un poco más como una sola. Por el camino, la GPU de centro de datos se dejó atrás los gráficos: según el documento técnico de la H100, sólo 4 de sus 132 multiprocesadores pueden ejecutar los shaders que dibujan un videojuego. Es un chip para multiplicar matrices que ha conservado el nombre.
Los chips propios. El primero que llegó a producción fue de Google. En 2013, una previsión interna calculó que si cada usuario hablaba tres minutos al día con la búsqueda por voz, que funcionaba con redes neuronales, Google tendría que doblar sus centros de datos. Google se puso a diseñar un chip propio para la inferencia (para entrenar, compró GPU) y en 15 meses lo tenía funcionando. La TPU (tensor processing unit, unidad de procesamiento de tensores) es un ASIC (application-specific integrated circuit), un chip diseñado para una sola tarea, y está en los centros de datos de Google desde 2015.
Su corazón es una matriz sistólica, una idea de finales de los años setenta: una cuadrícula de 256 × 256 celdas que multiplican y suman, 65 536 en total, por la que los datos avanzan de celda en celda. Los parámetros se cargan en las celdas y los datos entran por la izquierda. Cada celda multiplica el dato que le llega por su parámetro, suma el producto al resultado parcial que le pasa la celda de arriba y entrega la suma a la de abajo, mientras el dato sigue hacia la derecha. Un número leído de memoria se usa 256 veces sin volver a ella. Según el artículo en el que Google la describió, era de media entre 15 y 30 veces más rápida que la CPU y la GPU de su época, y hacía entre 30 y 80 veces más operaciones por vatio.
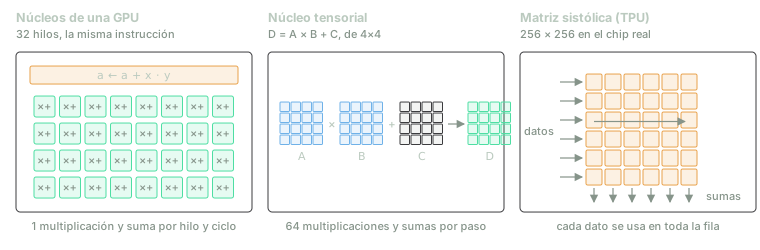
Tres formas de hacer la misma operación. De izquierda a derecha, cada número leído de memoria se reutiliza más veces dentro del circuito.
Hoy Google entrena sus modelos Gemini en TPU, y la séptima generación, Ironwood (2025), hace 4 614 TFLOPS en FP8 con 192 GB de HBM a 7,4 TB/s, en grupos de hasta 9 216 chips. Google la presentó como la primera de sus TPU pensada sobre todo para la inferencia. Y no las usa sólo Google: en octubre de 2025, Anthropic, la empresa que desarrolla los modelos Claude, anunció que usaría hasta un millón.
Las grandes nubes tienen los suyos: Amazon, Trainium para entrenar e Inferentia para inferir; Meta, MTIA (Meta Training and Inference Accelerator); Microsoft, Maia. Y varias empresas jóvenes han hecho apuestas más arriesgadas.
- Cerebras fabrica un chip del tamaño de una oblea de silicio entera, con 900 000 núcleos y 44 GB de SRAM, la memoria rápida con la que se hacen las cachés, dentro del propio chip.
- Groq diseñó un chip para inferencia que guarda los parámetros en SRAM en lugar de en HBM, para que la decodificación no espere a la memoria. En diciembre de 2025, NVIDIA compró una licencia no exclusiva de su tecnología y fichó a su fundador, por una cifra que la prensa situó en unos 20 000 millones de dólares.
- Etched anunció en 2024 un chip que sólo sabe ejecutar transformers: renuncia a todo lo demás a cambio de hacer eso más deprisa.
En los móviles y los portátiles, las NPU (neural processing unit, unidad de procesamiento neuronal), pequeñas unidades de matrices dentro del procesador, ejecutan modelos sin gastar la batería en la GPU. Muchos de estos chips empezaron por la inferencia, y no por casualidad: es el problema de la sección anterior, el que depende del ancho de banda y del coste de cada token, y donde una GPU de propósito general deja más margen.
Por qué la GPU sigue mandando. Aun con tantos chips específicos, los de NVIDIA suman más del 60 % de la capacidad de cálculo para IA vendida desde 2022, según las estimaciones de Epoch AI, un grupo de investigación independiente que estudia las tendencias del sector, y Google y Amazon se reparten buena parte del resto. Hay tres razones.
El software. CUDA existe desde 2007, y todo lo que se ha escrito encima (bibliotecas de matrices, PyTorch, los trucos de cada laboratorio) funciona primero ahí. Un chip nuevo necesita su compilador, sus bibliotecas y programadores que sepan usarlo, y Google tuvo que construirse los suyos para la TPU.
El tiempo. Diseñar un chip y llevarlo a producción lleva años, y los modelos cambian más deprisa. La primera TPU se diseñó para las redes que Google usaba entonces, tres tipos que sumaban el 95 % de su inferencia, y ninguno era un transformer, que llegó dos años después. Sobrevivió al cambio porque había apostado por la multiplicación de matrices, no por una red concreta. Un chip que sólo ejecuta transformers, como el de Etched, es la apuesta contraria: si la arquitectura cambia, el chip se queda atrás. La GPU, programable, se adapta a lo que venga.
La escala. Durante veinte años, los videojuegos pagaron el desarrollo de la GPU; ahora lo pagan los centros de datos. Y lo que se vende por millones se abarata y mejora más deprisa que lo que se vende por miles.
La gran diferencia con 1999 es ésa. Entonces la CPU no podía hacer el trabajo, y hoy la GPU lo hace bien. Un chip nuevo no compite con un procesador que no sirve, sino con uno que mejora cada dos años y que, además, absorbe las ideas de sus rivales: los núcleos tensoriales son, en pequeño, la misma idea que la matriz sistólica de la TPU, y NVIDIA ya tiene licencia de la tecnología de Groq.
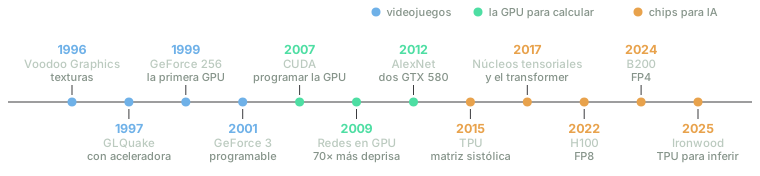
No a escala. La misma operación pasa de la CPU a un chip de juegos y, de ahí, a chips que ya sólo hacen eso.
Qué te llevas
Si te llevas una sola cosa, que sea ésta: la GPU no encaja en la IA por casualidad. Un videojuego y un modelo de lenguaje hacen el mismo tipo de trabajo, la misma operación pequeña sobre millones de datos independientes, sin decisiones y reutilizando cada número muchas veces, y la CPU está diseñada para lo contrario: un solo hilo de instrucciones, rápido y lleno de decisiones. Los videojuegos tuvieron que inventarse la GPU, y la IA la heredó.
Los mismos pasos, uno al lado del otro:
| Videojuegos | Modelos de lenguaje | |
|---|---|---|
| Qué se calcula | Cada vértice por una matriz de 4×4, y el color de cada píxel | Cada token por matrices de miles por miles, capa tras capa |
| Cuánto | Casi 500 millones de píxeles por segundo, a 4K y 60 fotogramas por segundo | operaciones para entrenar Llama 3 405B; por token generado |
| Límite de tiempo | 16,7 ms por fotograma | Decenas de milisegundos por token |
| Por qué no la CPU | Un núcleo, hecho para un hilo con decisiones | Entre cuatro y diez veces menos cálculo y ancho de banda, y pocas por servidor |
| El chip propio | La GPU (1999) | Núcleos tensoriales, TPU y los demás (desde 2015) |
Y si te llevas tres cosas más, que sean prácticas.
Pregunta siempre qué limita, el cálculo o la memoria. Cuenta cuántas operaciones hace un cálculo por cada byte que lee y compáralo con lo que el chip calcula por cada byte que le da su memoria. Si queda por debajo, comprar más aritmética no lo acelera.
Para generar texto, cuenta bytes, no operaciones. La velocidad de la decodificación para una persona es, como mucho, el ancho de banda de la memoria dividido entre lo que ocupa el modelo. Por eso cuantizar acelera, y por eso un portátil con buena memoria ejecuta modelos pequeños.
El nombre «GPU» es historia. Lo que importa de un chip para IA es cuántas multiplicaciones de matrices hace por segundo, en qué precisión, cuántos bytes por segundo le llegan y con cuántos más se puede conectar. Y, detrás, el software que sabe usarlo.
En 1999, una tarjeta para jugar le quitó a la CPU una multiplicación por una matriz de 4×4. Veinticinco años después, esa misma operación, con matrices de miles de filas, es la que entrena los modelos de lenguaje. Los chips han cambiado de tamaño, de nombre y hasta de dueño; la operación sigue siendo la misma.