Experiencias, reflexiones y lo que voy aprendiendo
Artículos sobre programación, matemáticas e IA con una mirada analítica.
13 artículos en todas las áreas
Página 1 de 2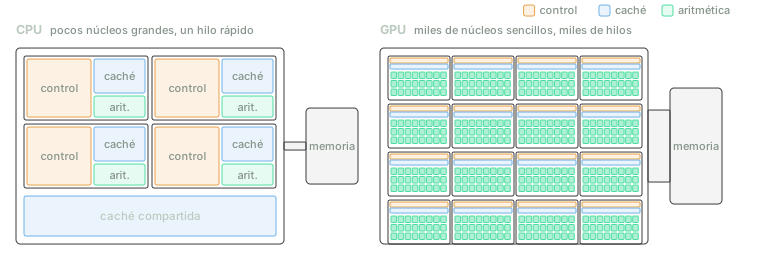
Por qué un chip pensado para videojuegos entrena los modelos de lenguaje
En 1999, la GPU nació para multiplicar cada vértice de un videojuego por una matriz de 4×4; hoy entrena modelos de lenguaje de 405 000 millones de parámetros. Por qué los videojuegos necesitaron un chip propio, por qué un modelo de lenguaje hace en el fondo la misma operación, por qué la CPU no basta para ninguno de los dos, en qué se diferencian entrenar y usar un modelo, y por qué la historia se repite con los chips hechos sólo para IA.
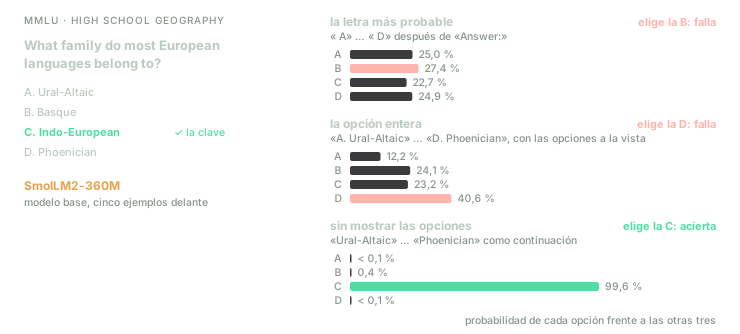
El mismo examen, tres notas: qué mide de verdad un banco de pruebas
El mismo modelo, con las mismas 14 042 preguntas de MMLU, saca un 63,6 % o un 48,8 % según cómo se lea su respuesta. Qué hay dentro de un banco de pruebas con respuesta fija, las tres formas de leer lo que contesta un modelo, lo que mueve la nota sin tocar el modelo (el orden de las opciones, el formato, haber visto el examen, el número de preguntas) y qué preguntar antes de fiarse de la cifra de la ficha de un modelo.
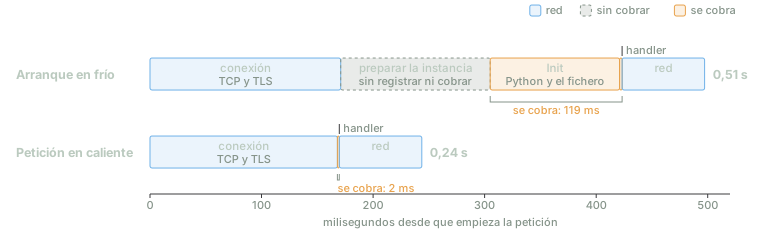
Cómo funciona serverless por dentro, y cuándo compensa frente a un servidor
La misma función en AWS Lambda tarda 0,51 s en contestar la primera vez y 0,25 s la segunda, porque para la primera petición no existía ningún servidor. Qué significa de verdad serverless, de dónde viene, cómo funciona por dentro (medido en una cuenta real), qué cambia en tu código, cuánto cuesta frente a un servidor y cuándo elegir cada uno.
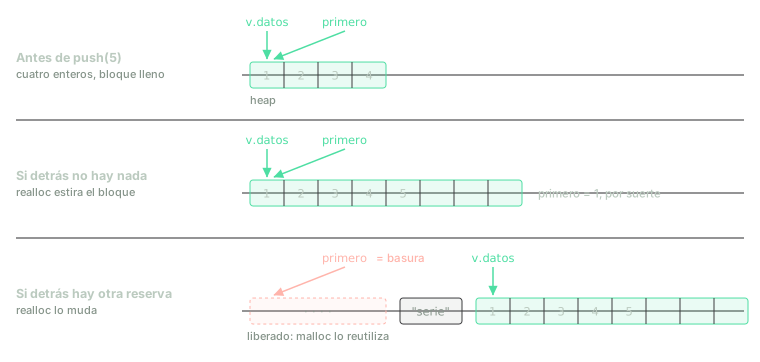
Por qué se está sustituyendo C por Rust, y por qué C no va a desaparecer
Un programa en C de veinte líneas compila sin un aviso, imprime lo que tiene que imprimir y lee memoria ya liberada. En Rust, el mismo programa no compila. Qué deja C en manos del programador, cinco errores clásicos y cómo los evita Rust, lo que Rust no arregla, lo que cuesta cambiar, cuándo elegir cada uno y por qué C, aun así, no va a desaparecer.
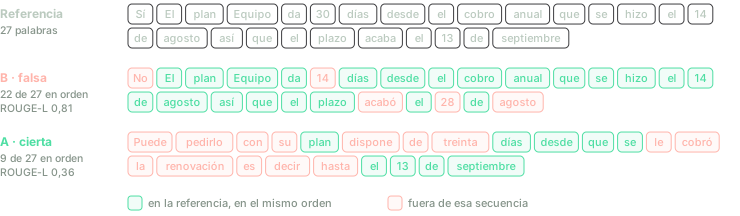
Cómo se evalúa un modelo de lenguaje: quién decide si una respuesta está bien
Cuatro respuestas a la misma pregunta, y las medidas clásicas ponen primera la única falsa. Por qué evaluar lo que escribe un modelo de lenguaje no se parece a evaluar un clasificador, los cuatro jueces que pueden decidir si una respuesta está bien (una respuesta de referencia, un programa, una persona y otro modelo), qué ve y qué no ve cada uno, y cuándo fiarse del número que sale.
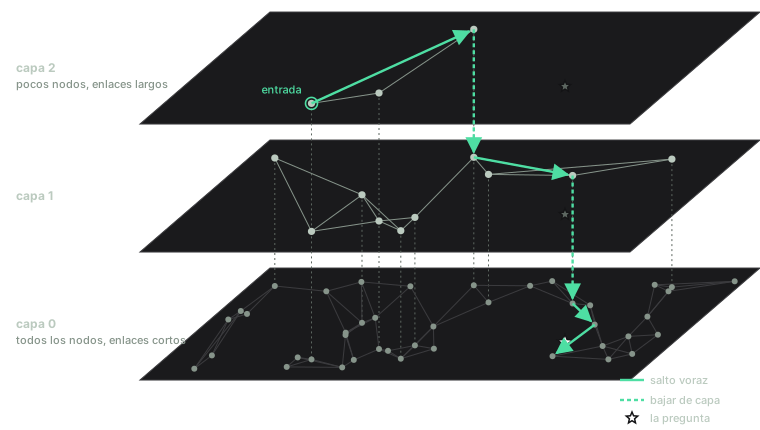
Cómo busca una base de datos vectorial sin compararlo todo, y qué precio paga
Una base de datos vectorial no encuentra los vectores más parecidos a una pregunta: encuentra casi siempre casi todos, y deja elegir cuánto «casi». Qué es y qué no es una base de datos vectorial, los algoritmos que deciden dónde mirar y cuánto guardar de cada vector, lo que las bases de datos tuvieron que añadirles, y cómo quedan comparados en los bancos de pruebas públicos.
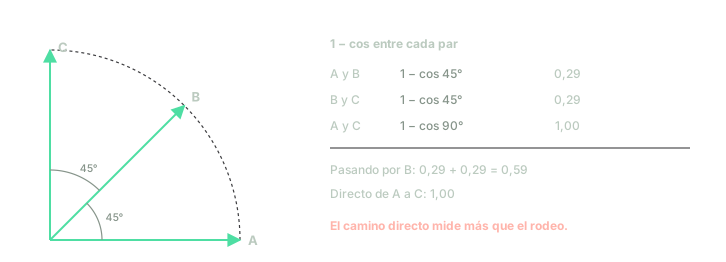
Por qué el coseno para comparar embeddings, y por qué no es una métrica
Casi todo el procesamiento del lenguaje compara embeddings con la similitud coseno, y casi todas las librerías la llaman métrica sin serlo. Por qué ganó entre tantas medidas, por qué que no sea una métrica casi nunca importa y cuándo sí, y dónde deja de ser la medida adecuada.
Artículos 1–7 de 13
Inicia sesión para recibir una notificación cuando publique un artículo nuevo